AI i automatyzacja
Ustrukturyzowane odpowiedzi AI w automatyzacji: od poprawnego JSON do bezpiecznej akcji
Jak połączyć JSON Schema, reguły domenowe, fallback i audyt, aby odpowiedź AI nie uruchamiała błędnej akcji downstream.
Odpowiedź AI może przejść parser, spełnić JSON Schema i nadal uruchomić złą operację. To nie jest argument przeciwko structured output. To argument przeciwko traktowaniu formatu jako dowodu, że decyzja jest poprawna.
W automatyzacji model często nie kończy pracy na ekranie. Jego wynik zasila CRM, system zamówień, workflow reklamacji albo kolejny serwis. Gdy wyjściem jest swobodny tekst, problem zaczyna się od parsowania. Gdy wyjściem jest ustrukturyzowany JSON, parser przestaje być głównym problemem, ale pozostają pytania o sens danych, próg ryzyka i możliwość zatrzymania akcji.
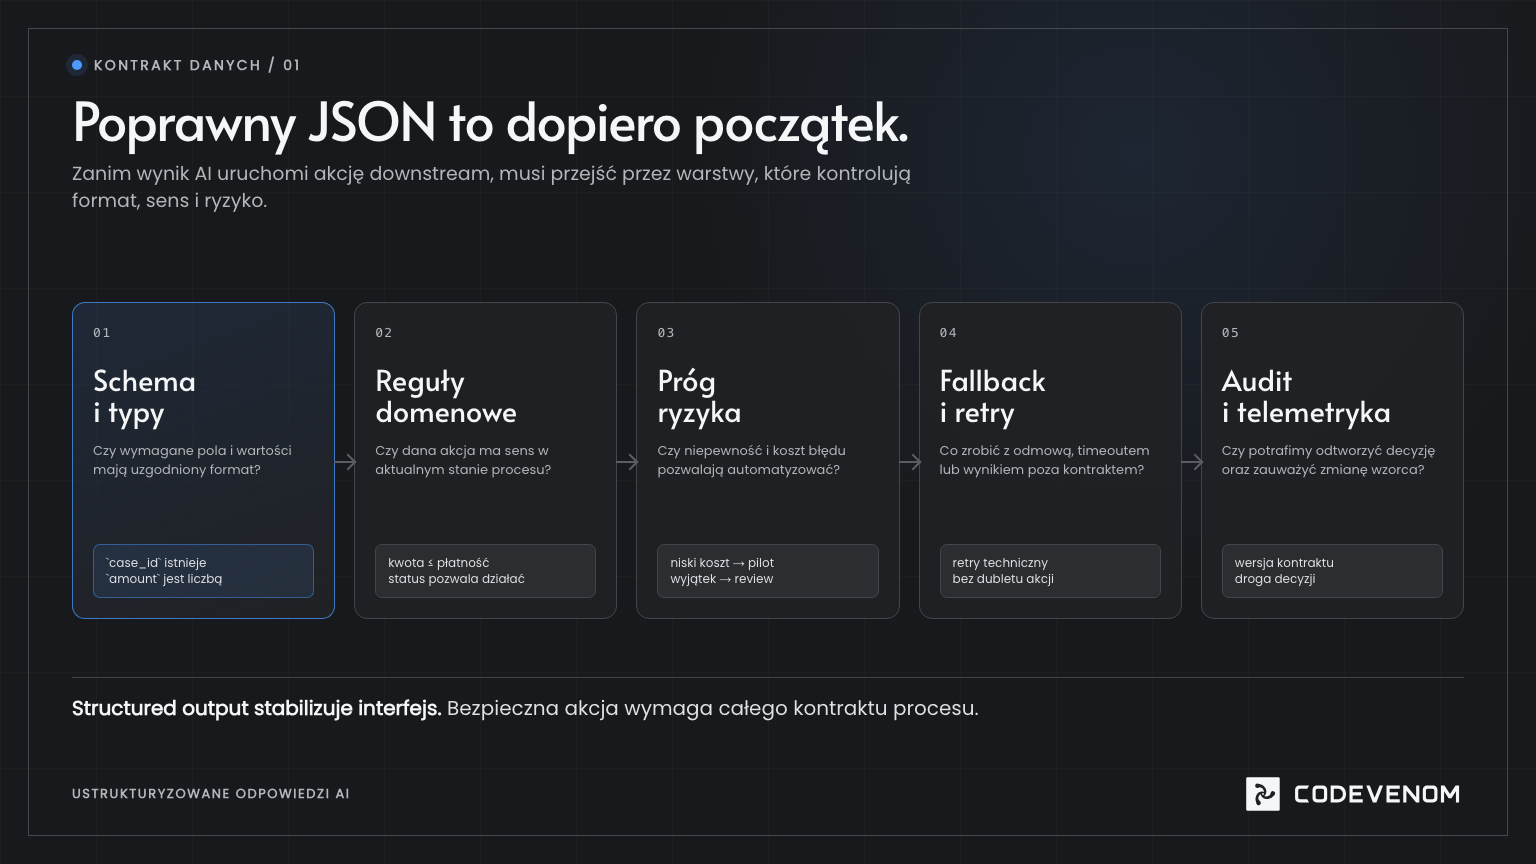
Krótka odpowiedź: ustrukturyzowane odpowiedzi stabilizują interfejs między modelem a software. Bezpieczna automatyzacja wymaga jednak pięciu warstw: schema i typów, reguł domenowych, oceny niepewności, fallbacku oraz telemetrii. Każda z nich zatrzymuje inny rodzaj błędu.
Rodzaj błęduCo go wykrywaCo powinno wydarzyć się dalejBrakuje wymaganego pola albo typ jest nieprawidłowyschema i validatorodrzucenie wyniku lub kontrolowany retryJSON jest poprawny, ale kwota lub status nie mają sensureguły domenowebrak akcji i skierowanie do reviewModel jest niepewny albo dane wejściowe są sprzecznepróg pewności i polityka procesuzebranie danych, fallback lub człowiekDostawca nie odpowiada albo wynik jest niekompletnyobsługa błędów i retry policybezpieczne wznowienie bez duplikowania akcjiWzorzec błędów się zmieniatelemetria i audytograniczenie automatyzacji, diagnoza, korekta
Model językowy dobrze radzi sobie z wyjaśnieniem sprawy, streszczeniem rozmowy czy przygotowaniem propozycji. To nie znaczy, że tekst jest stabilnym interfejsem dla drugiego systemu. Nawet dobra instrukcja może dać inną kolejność pól, dodatkowy komentarz, nieoczekiwaną kategorię albo odpowiedź, która urywa się w połowie.
Parsing, brakujące pola i zmiana formatu
Wyobraźmy sobie automatyzację, która z korespondencji ma przygotować propozycję zwrotu. Wynik tekstowy może brzmieć rozsądnie dla człowieka, ale parser nie wie, czy „zwrot pełny” oznacza konkretną wartość, jaką walutę wybrać i czy decyzja jest propozycją, czy poleceniem wykonania.
JSON Schema pozwala nazwać oczekiwaną strukturę: wymagane pola, typy, dozwolone wartości i część ograniczeń. To jest formalny opis danych, a validator sprawdza zgodność konkretnego dokumentu z tym opisem. JSON Schema definiuje strukturę i ograniczenia danych JSON, ale do sprawdzenia instancji potrzebny jest validator.
W systemach obsługujących tę funkcję structured output może wymusić zgodność odpowiedzi modelu ze zdefiniowanym schematem. Dokumentacja OpenAI rozróżnia JSON mode, który daje poprawny JSON, od Structured Outputs, które dodatkowo pilnują zgodności ze schematem. To usuwa dużą część kruchego kodu parsującego. Nie tworzy jednak automatycznie poprawnej polityki biznesowej.
Błąd semantyczny mimo poprawnego JSON
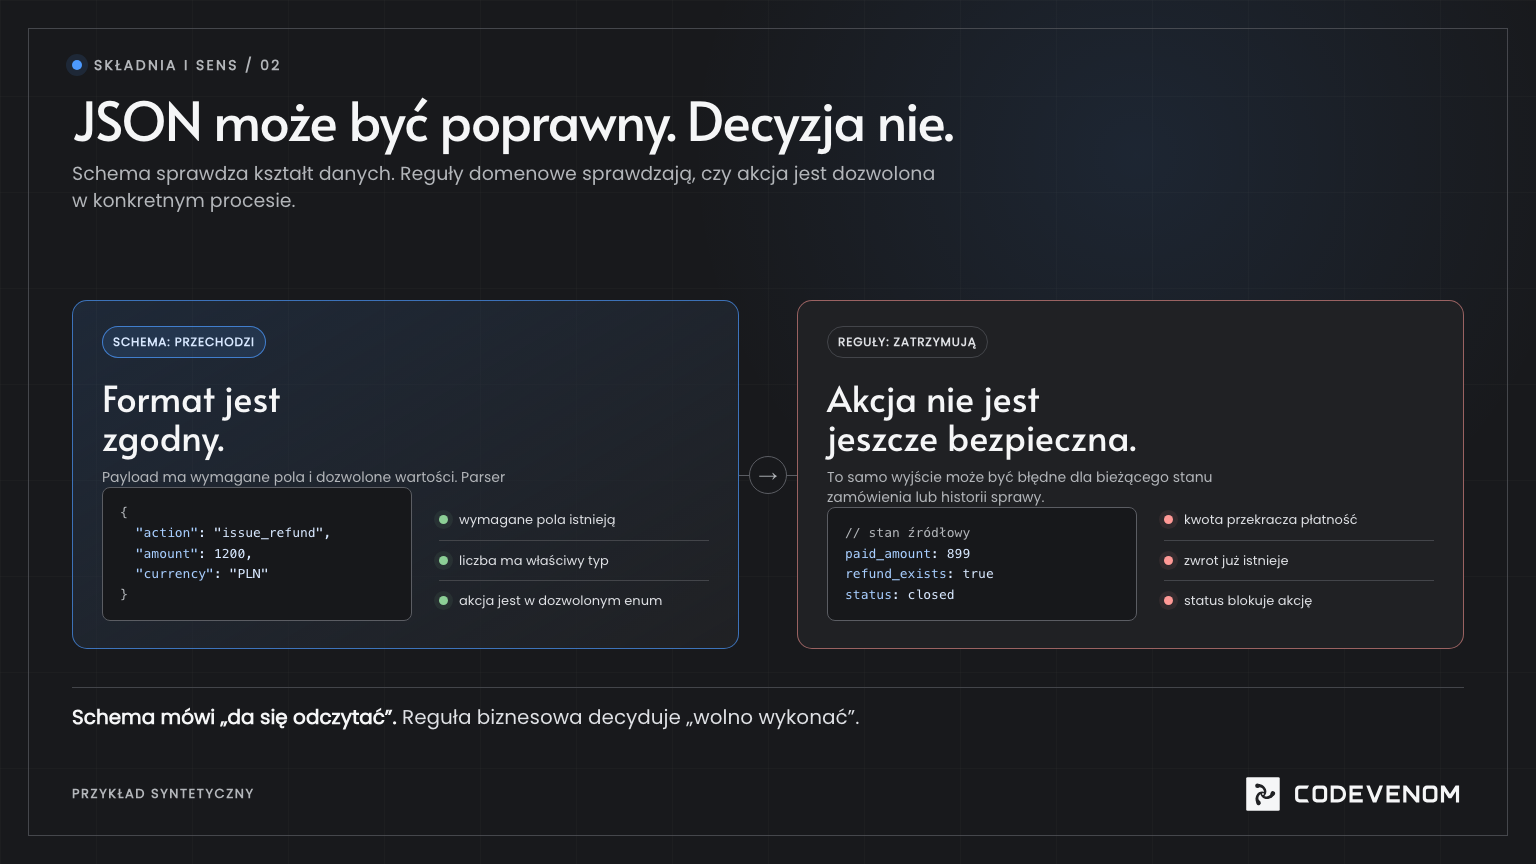
Załóżmy, że model zwraca:
{ "action": "issue_refund", "amount": 1200, "currency": "PLN", "reason": "damaged_delivery" }
Ten obiekt może być zgodny ze schematem. Mimo to system powinien jeszcze sprawdzić, czy zamówienie zostało opłacone, czy kwota nie przekracza wartości transakcji, czy reklamacja ma właściwy status, czy nie ma już zwrotu dla tego samego przypadku i czy dana osoba ma prawo zatwierdzić wyjątek.
Schema odpowiada na pytanie: „czy dane mają uzgodniony kształt?”. Reguły domenowe odpowiadają na inne: „czy w tym konkretnym stanie procesu ta akcja ma sens i jest dozwolona?”. Te odpowiedzi nie powinny być mylone.
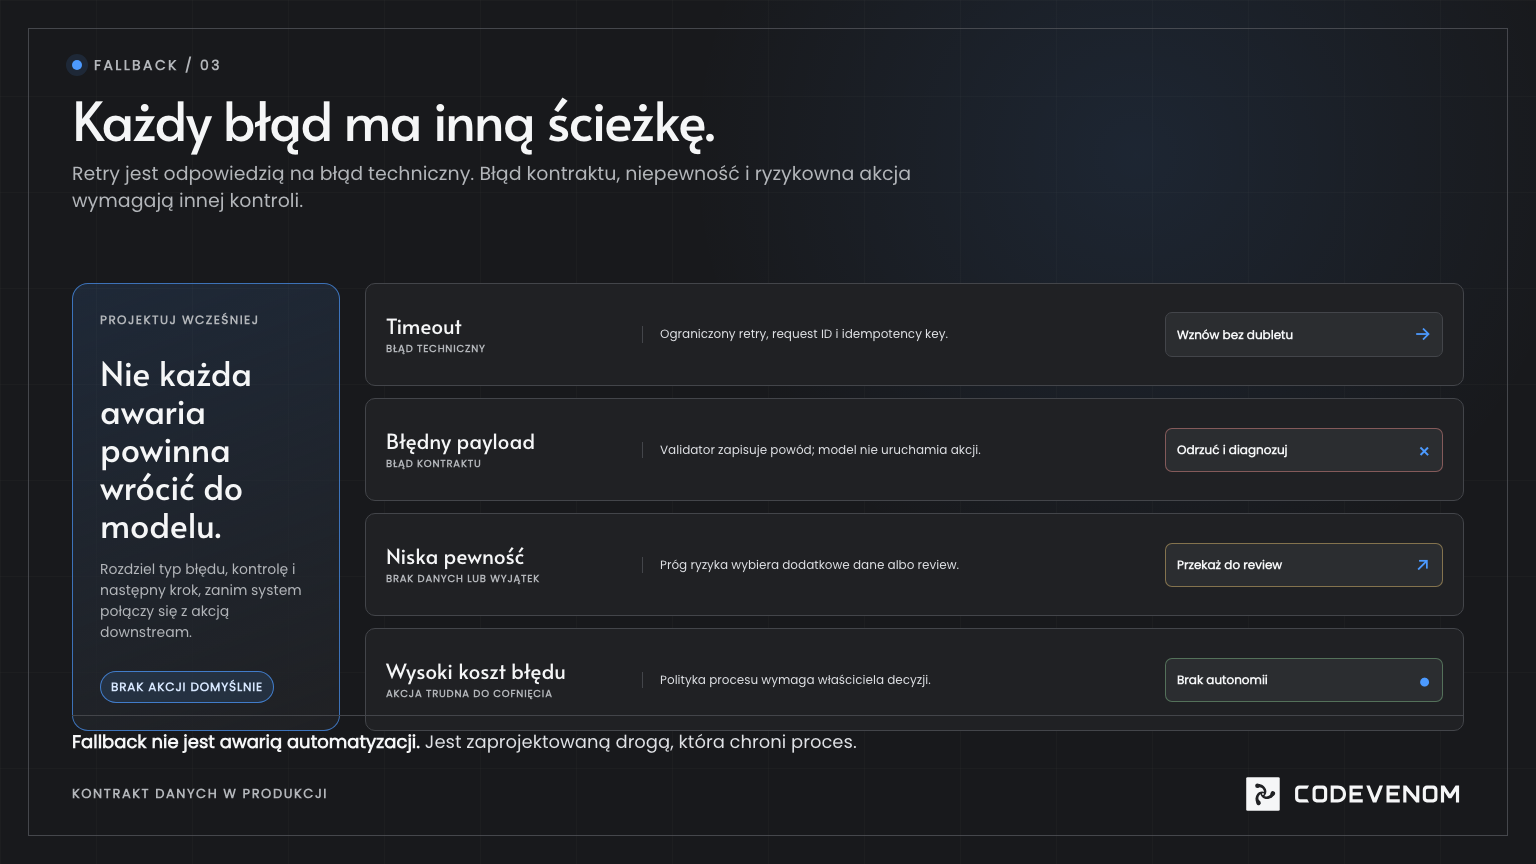
Najprościej myśleć o wyniku modelu jak o kandydacie do wykonania pracy, a nie o gotowej komendzie. Każda warstwa ma jawny wynik: przepuść, zatrzymaj, spróbuj ponownie, poproś o dane albo przekaż człowiekowi.
1. Schema i typy: ustal wspólny język systemów
Kontrakt powinien mówić, które pola są wymagane, jakie mają typy, które wartości enum są dozwolone i czy pola dodatkowe są akceptowane. To ogranicza awarie typu: brak identyfikatora, tekst zamiast liczby, nowa kategoria, której system downstream nie zna.
Warto projektować kontrakt dla odbiorcy danych, a nie dla wygody promptu. Jeśli kolejny system potrzebuje case_id, proposed_action, reason_code i evidence, te pola powinny być jawne. Opisowy akapit w polu notes nie jest zamiennikiem dla danych, po których ma działać workflow.
Jednocześnie trzeba obsłużyć przypadki poza normalnym wynikiem. Nawet przy structured output dostawca może zwrócić odmowę, a odpowiedź może być niepełna z powodów technicznych. Oficjalna dokumentacja OpenAI wskazuje, że odmowa może nie podążać za dostarczonym schematem i wymaga osobnej obsługi w kodzie. To jest ścieżka procesu, nie wyjątek, który można pominąć.
2. Reguły domenowe i zakresy: sprawdź sens, nie tylko format
Walidator schematu może sprawdzić, że amount jest liczbą dodatnią. Reguła domenowa powinna sprawdzić, że kwota jest mniejsza lub równa zapłaconej wartości, waluta pasuje do zamówienia, a akcja jest dostępna w bieżącym statusie sprawy.
Ta warstwa powinna korzystać z danych źródłowych systemu, nie z treści wygenerowanej przez model. Model może zaproponować kategorię lub wydobyć informację z dokumentów. System powinien sam pobrać stan zamówienia, uprawnienia i historię wcześniejszych akcji.
Jeśli owner procesu nie potrafi nazwać reguły, nie należy udawać, że model ją „odkryje”. To sygnał, że decyzja wymaga doprecyzowania polityki albo review człowieka.
3. Niepewność: traktuj confidence jak sygnał, nie zgodę na działanie
Nie każdy model udostępnia porównywalną miarę pewności, a wartość nazwana confidence nie jest sama w sobie dowodem jakości. Jeżeli jest dostępna, trzeba ją sprawdzić na własnym zbiorze przypadków i dla konkretnej klasy zadań.
Próg powinien zależeć także od odwracalności akcji. Wysłanie roboczej notatki do kolejki wewnętrznej można obserwować i skorygować. Zmiana ceny, zwrot środków czy wysłanie komunikatu do klienta mają inny koszt błędu. W drugim przypadku wysoka deklarowana pewność nie powinna zastępować kontroli domenowej lub uprawnienia człowieka.
4. Retry i fallback: nie ponawiaj ryzykownej akcji w ciemno
Retry ma sens dla przejściowego problemu technicznego, na przykład timeoutu przed otrzymaniem wyniku. Nie jest dobrą domyślną reakcją na odrzucony payload, sprzeczne dane albo niejednoznaczną decyzję. Kolejna próba z tym samym niejasnym wejściem może tylko powielić błąd.
Zaprojektuj osobne ścieżki:
-
błąd techniczny: ograniczony retry z identyfikatorem żądania i limitem prób;
-
błąd kontraktu: brak akcji, zapis powodu i poprawa danych lub promptu;
-
brak pewności albo wyjątek: zebranie dodatkowych danych, reguła zastępcza lub review;
-
akcja nieodwracalna: wymaganie jawnego zatwierdzenia przed wywołaniem downstream.
Idempotency key i zapis stanu są tu równie ważne jak sam model. Bez nich ponowione żądanie może utworzyć dwa zgłoszenia lub dwa razy wykonać tę samą operację.
5. Telemetria i audyt: zobacz, co system naprawdę robi
Bez obserwowalności zespół widzi tylko końcową awarię albo pojedynczą skargę. Warto logować wersję kontraktu, wejściowy identyfikator sprawy, wynik walidacji, wybraną ścieżkę fallbacku, czas odpowiedzi i rezultat akcji downstream. Dane wrażliwe należy przy tym minimalizować lub maskować zgodnie z polityką firmy.
Audyt ma odpowiedzieć na konkretne pytania: które pole najczęściej nie przechodzi walidacji, czy liczba review rośnie dla nowej kategorii spraw, czy retry powoduje duplikaty oraz czy zmiana promptu poprawiła jeden wskaźnik kosztem innego. Bez tej warstwy automatyzacja wygląda stabilnie aż do momentu, gdy błąd trafia do klienta.
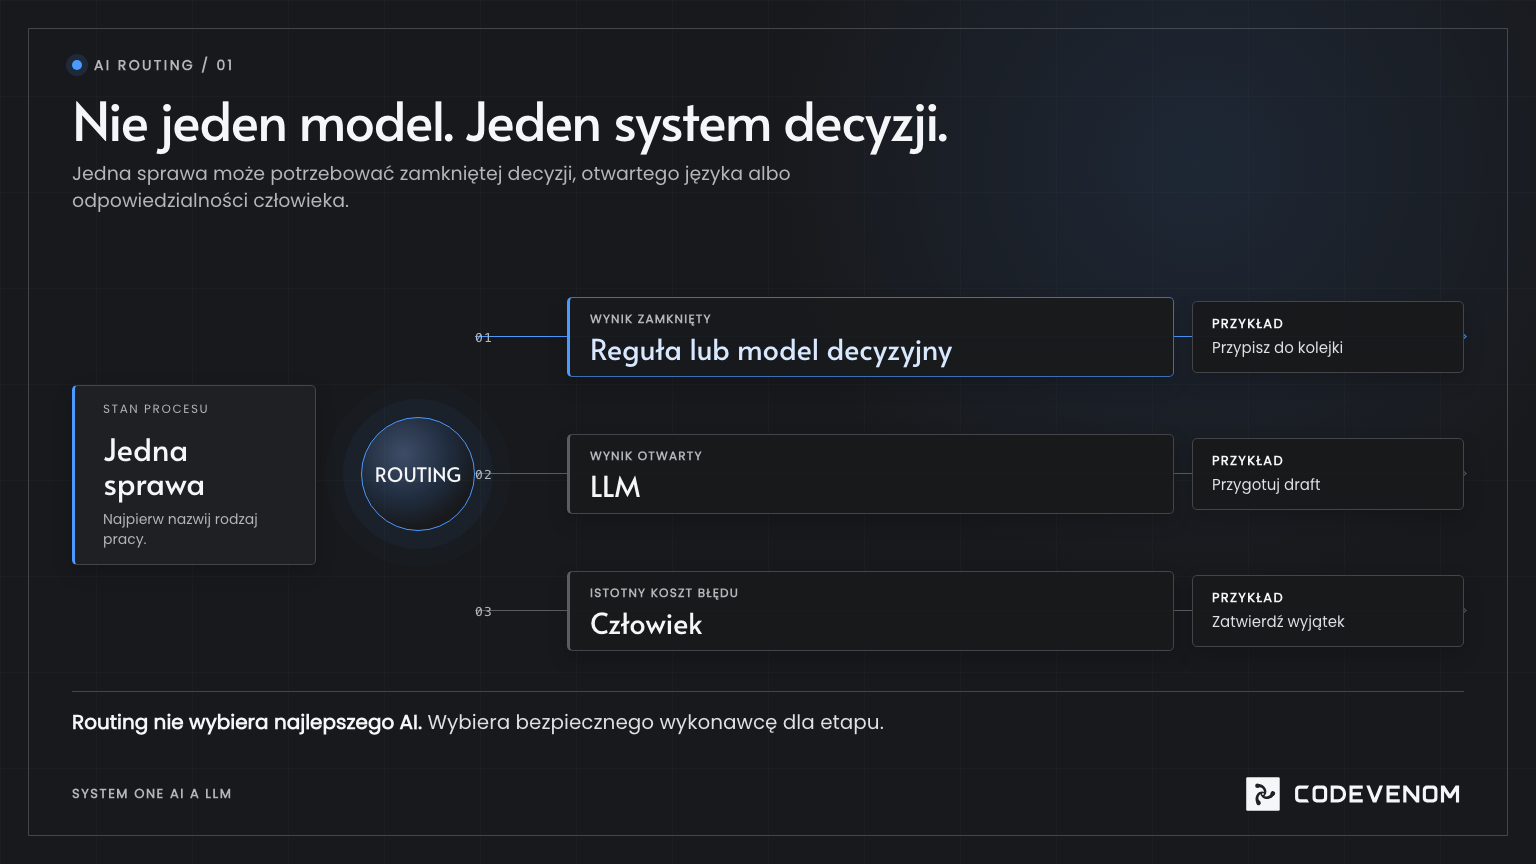
Structured output nie odpowiada na pytanie, czy LLM w ogóle powinien podejmować daną decyzję. Najpierw warto określić rodzaj wyniku.
Rodzaj pracyDobry punkt wyjściaRola kontraktuJednoznaczny warunek, np. wymagane pole nie istniejeregułaprzekazuje jasny status do kolejnego systemuOtwarta praca na treści, np. wydobycie kontekstu z mailaLLMzamienia propozycję modelu w przewidywalny obiekt danychWybór z zamkniętej listy na podstawie wielu sygnałówmodel decyzyjny albo regułyopisuje opcje, dane wejściowe i granice eskalacjiWyjątek o wysokim koszcieczłowiekprzekazuje kontekst, propozycję i ślad decyzji
LLM może przygotować kandydacką akcję, ale nie powinien ukrywać braku polityki biznesowej. Jeżeli wynik ma zamkniętą formę, a koszt błędu jest znaczący, potrzebna jest jawna ścieżka wyboru i odpowiedzialności. Jak dobrać wykonawcę do rodzaju zadania, opisujemy szerzej w artykule o System One AI, LLM i human fallback.
W osobnym materiale pokazujemy też Jev jako potencjalną alternatywę dla wybranych, ustrukturyzowanych decyzji. Nie wynika z tego, że każdy proces wymaga nowego modelu. Często najpierw trzeba uporządkować kontrakt oraz reguły.
Pierwsza wersja nie musi obejmować całego procesu. Wybierz jedną akcję o ograniczonym zasięgu i poprowadź ją przez pełny łańcuch kontroli:
wejście → LLM → schema → reguły domenowe → próg ryzyka → fallback albo akcja downstream → audit
Najważniejsze jest rozdzielenie etapów. Model zwraca propozycję. Walidator sprawdza kontrakt. System biznesowy sprawdza aktualny stan. Dopiero potem mechanizm wykonawczy otrzymuje zgodę na działanie. Dzięki temu można wymienić model albo prompt bez zmieniania zasad, które chronią proces.
Contract tests i zestaw przypadków negatywnych
Przed podłączeniem akcji przygotuj mały zestaw testowy obok standardowych przykładów „wszystko działa”. Powinien zawierać między innymi:
-
brak identyfikatora sprawy, nieznaną wartość enum i liczbę w polu tekstowym;
-
poprawny formalnie payload z kwotą poza zakresem albo statusem niezgodnym z procesem;
-
dwie sprzeczne informacje w źródłach;
-
timeout oraz ponowienie tego samego requestu;
-
sprawę, która ma trafić do człowieka, nie do automatu.
Nie chodzi o uzyskanie deklaracji „zero błędów”. Chodzi o to, aby zespół przed produkcją wiedział, który błąd zatrzyma system, który zostanie zapisany, a który wymaga decyzji ownera.
Przed uruchomieniem automatyzacji odpowiedz na te pytania:
-
Czy wynik ma wersjonowany schema z wymaganymi polami i ograniczonymi wartościami?
-
Które reguły biznesowe są sprawdzane na danych źródłowych, a nie w odpowiedzi modelu?
-
Czy system odróżnia błąd techniczny, błąd kontraktu, brak pewności i odmowę modelu?
-
Jaka akcja jest odwracalna, a która wymaga zatwierdzenia człowieka?
-
Jak system uniknie duplikatu po retry?
-
Kto jest ownerem kontraktu i kto może zmienić regułę lub próg?
-
Jakie zdarzenia zostaną zapisane, aby po tygodniu można było odtworzyć decyzję?
Jeżeli na któreś z pytań nie ma odpowiedzi, bezpieczniejszym pierwszym krokiem jest tryb rekomendacji lub review. To nadal może dawać wartość operacyjną, bez udawania autonomicznej automatyzacji.
Nie ma uniwersalnego progu, od którego można „włączyć AI”. Oceń każdą akcję przez pięć kryteriów: koszt błędu, wykrywalność, odwracalność, dostępność fallbacku i jakość danych wejściowych. Akcja tania do cofnięcia może przejść przez mały pilot. Akcja finansowa, prawna lub trudna do wyjaśnienia powinna pozostać w review do czasu, aż zespół zbierze własne dowody jakości.
Punkt stop warto ustalić przed startem: na przykład wstrzymanie automatycznego wykonania po pojawieniu się nieobsłużonej kategorii, wzroście odrzuconych payloadów albo wykryciu duplikatów. Konkretne progi liczbowe zależą od procesu; nie są zweryfikowane bez jego historii i danych operacyjnych.
Najmniejszy bezpieczny krok to zanonimizować jeden rzeczywisty payload, przejść go offline przez wszystkie pięć warstw i dopiero potem zdecydować, czy akcję wolno podłączyć do systemu downstream.
Jeśli masz już proces, w którym odpowiedź AI ma zasilić kolejny system, rozpocznij projekt z CODEVENOM. W formularzu możesz opisać akcję downstream i przesłać anonimowy przykład payloadu. Zaczniemy od krótkiego przeglądu ryzyka kontraktu danych, nie od obietnicy pełnej automatyzacji.
Czy JSON Schema eliminuje halucynacje?
Nie. JSON Schema ogranicza strukturę i dozwolone wartości zgodnie z kontraktem, ale nie sprawdza, czy model prawidłowo zrozumiał dokument, czy przypisał właściwą przyczynę ani czy proponowana akcja jest poprawna w bieżącym procesie. Do tego potrzebne są dane źródłowe, reguły domenowe i odpowiednia ścieżka eskalacji.
Czy structured output gwarantuje poprawne dane?
Gwarancja dotyczy zgodności z obsługiwanym schematem, a nie prawdziwości lub biznesowego sensu informacji. Structured output zmniejsza klasę błędów integracyjnych. Nie zastępuje testów kontraktu, walidacji semantycznej ani kontroli przed akcją downstream.
Kiedy retry pogarsza sytuację?
Gdy powtarza niejasną decyzję lub może ponownie wykonać akcję, której system nie oznaczył jako idempotentnej. Retry jest narzędziem do kontrolowania błędów technicznych, nie sposobem na naprawienie sprzecznych danych, niezgodnego payloadu albo nieistniejącej reguły biznesowej.
Kiedy eskalować do człowieka?
Gdy dane są sprzeczne lub niepełne, przypadek wypada poza znane kategorie, wynik nie przechodzi kontroli domenowej albo koszt błędu jest wysoki i trudno go odwrócić. Człowiek powinien dostać propozycję systemu, dane, które ją uzasadniają, oraz możliwe kolejne kroki, a nie sam surowy tekst modelu.