AI i automatyzacja
Jev AI firmy TypeSafe: co to jest i kiedy ma sens pilotaż?
Jev AI zwraca typed decisions zamiast tekstu. Sprawdź, czym różni się od LLM i jak ocenić fit jednego workflow przed pilotażem.
Jev pojawił się z obietnicą, która brzmi atrakcyjnie dla zespołów budujących automatyzacje: zamiast generować tekst, model ma zwracać decyzje w formacie gotowym do użycia przez software. To może ograniczyć część problemów znanych z integracji LLM. Nie odpowiada jednak na ważniejsze pytanie: czy sama decyzja jest poprawna i czy można bezpiecznie wykonać ją w konkretnym procesie.
Dlatego Jev warto oceniać nie przez deklarowaną szybkość modelu, lecz przez jeden workflow, koszt błędu, dane historyczne i regułę eskalacji do człowieka.
Jev to pierwszy publiczny model z klasy System One Models rozwijanej przez TypeSafe AI. Przyjmuje opis stanu oraz zdefiniowane pytania, a następnie zwraca ustrukturyzowane odpowiedzi, rozkłady prawdopodobieństwa i, dla części typów pytań, confidence. Nie służy do swobodnego generowania tekstu jak typowy chatbot.
TypeSafe AI ogłosiło Jev 15 września 2026 roku. W chwili tej weryfikacji produkt był udostępniany w trybie early access. Producent przedstawia go jako model przeznaczony do szybkich, zamkniętych decyzji wykonywanych wewnątrz software.
Aktualna dokumentacja opisuje trzy podstawowe typy pytań:
-
Choice: wybór jednej opcji ze zdefiniowanego zbioru, na przykład działu, do którego ma trafić zgłoszenie;
-
Score: ocena na zdefiniowanej skali, na przykład poziomu pilności albo ryzyka;
-
Noul: prawdopodobieństwo odpowiedzi „tak” na jedno konkretne pytanie.
Każde pytanie ma być wąskie i dotyczyć jednego osądu. Gdy decyzja zależy od kilku czynników, producent zaleca rozdzielić je na osobne pytania, a sposób połączenia wyników zapisać w kodzie. To istotna różnica względem promptu, który prosi LLM o przeanalizowanie całego przypadku i wybranie dalszego działania w jednym kroku. Szczegóły tych prymitywów są opisane w dokumentacji TypeSafe.
Skąd nazwy System One i Jev?
Według producenta określenie „System One” nawiązuje do rozróżnienia szybkiego i wolnego myślenia. Nazwa Jev pochodzi natomiast od ekonomisty Williama Stanleya Jevonsa. TypeSafe łączy ją z hipotezą, że spadek kosztu maszynowej „inteligencji” zwiększy liczbę jej zastosowań.
To pochodzenie nazwy, nie dowód działania modelu ani synonim paradoksu Jevonsa. TypeSafe AI nie jest też dawną firmą Typesafe, która w 2016 roku zmieniła nazwę na Lightbend.
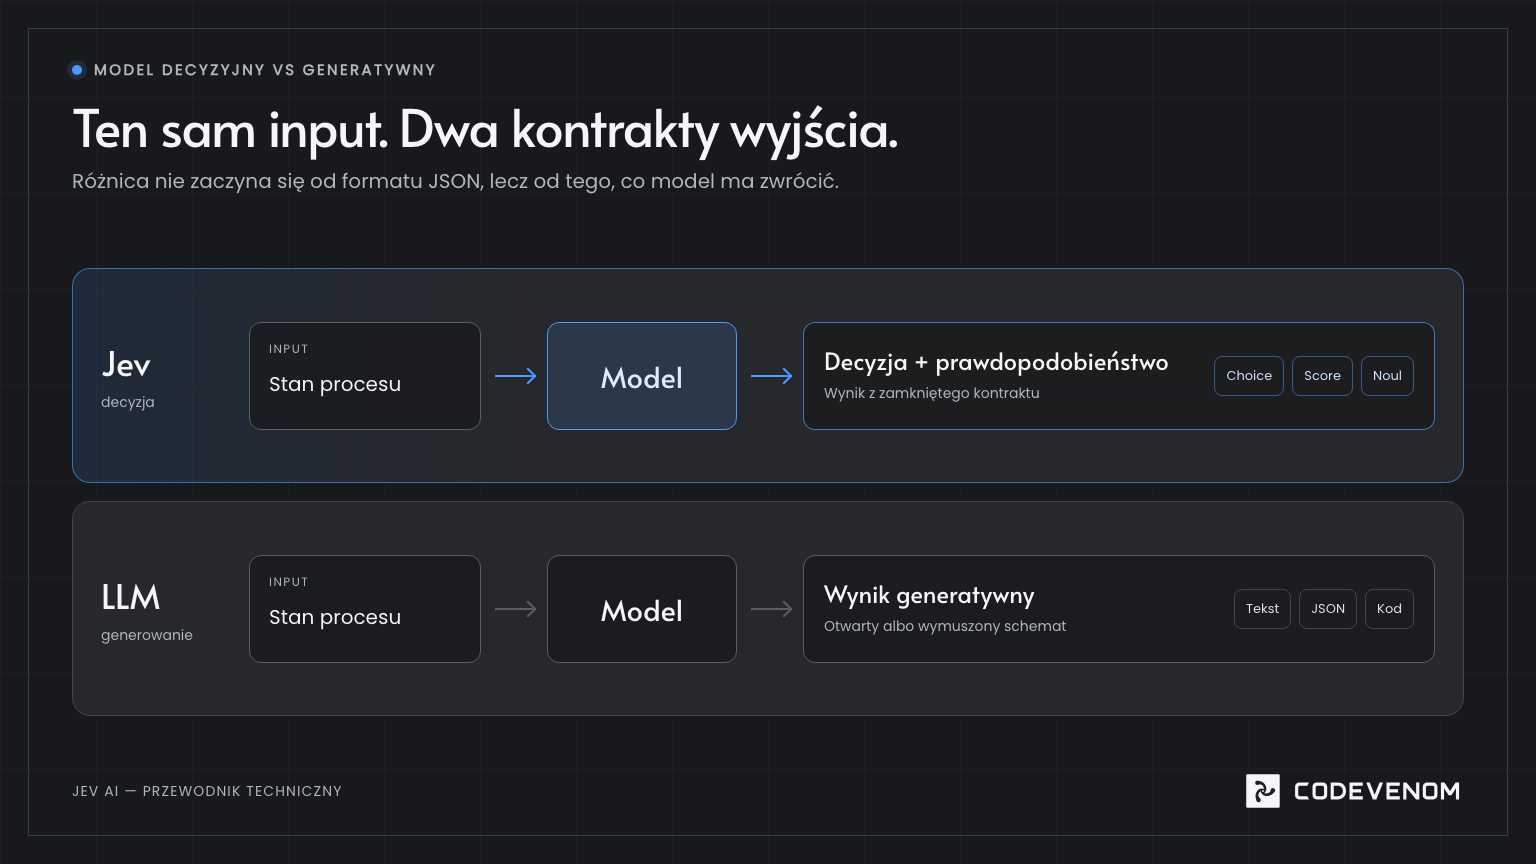
Najprościej porównać oba podejścia przez kontrakt wyjścia.
LLM generuje ciąg tekstu. Może zwrócić opis, odpowiedź klientowi, kod albo JSON. Współczesne modele potrafią też pracować ze schematem i structured outputs, więc samo hasło „ustrukturyzowany wynik” nie wystarcza jeszcze, aby uzasadnić zmianę technologii.
Jev jest pozycjonowany inaczej. Zbiór dopuszczalnych odpowiedzi definiuje się przed wywołaniem. Model nie ma napisać uzasadnienia ani wymyślić nowej kategorii. Ma ocenić przekazany stan i zwrócić wynik w jednym z dozwolonych typów.
KryteriumJevTypowy LLMPodstawowy wynikdecyzja z wcześniej określonego typugenerowany tekst lub strukturaOtwartość odpowiedzizamknięty zbiór opcji albo skalaod odpowiedzi otwartej po wymuszony schematNiepewnośćprobabilities; confidence dla Choice i Scorezależy od modelu i architektury integracjiNaturalne zastosowanieklasyfikacja, scoring, routing, warunek w kodzieopis, synteza, rozmowa, praca na otwartym zadaniuKontrola działaniaprogi i logika pozostają w kodziezwykle potrzebne są walidacja, retry i dodatkowe reguły
To porównanie nie oznacza, że Jev jest „lepszym LLM”. To inny kontrakt dla innej klasy zadań. Producent wręcz zaleca rozbijanie złożonego problemu na małe oceny, które software łączy zgodnie z regułami domeny.
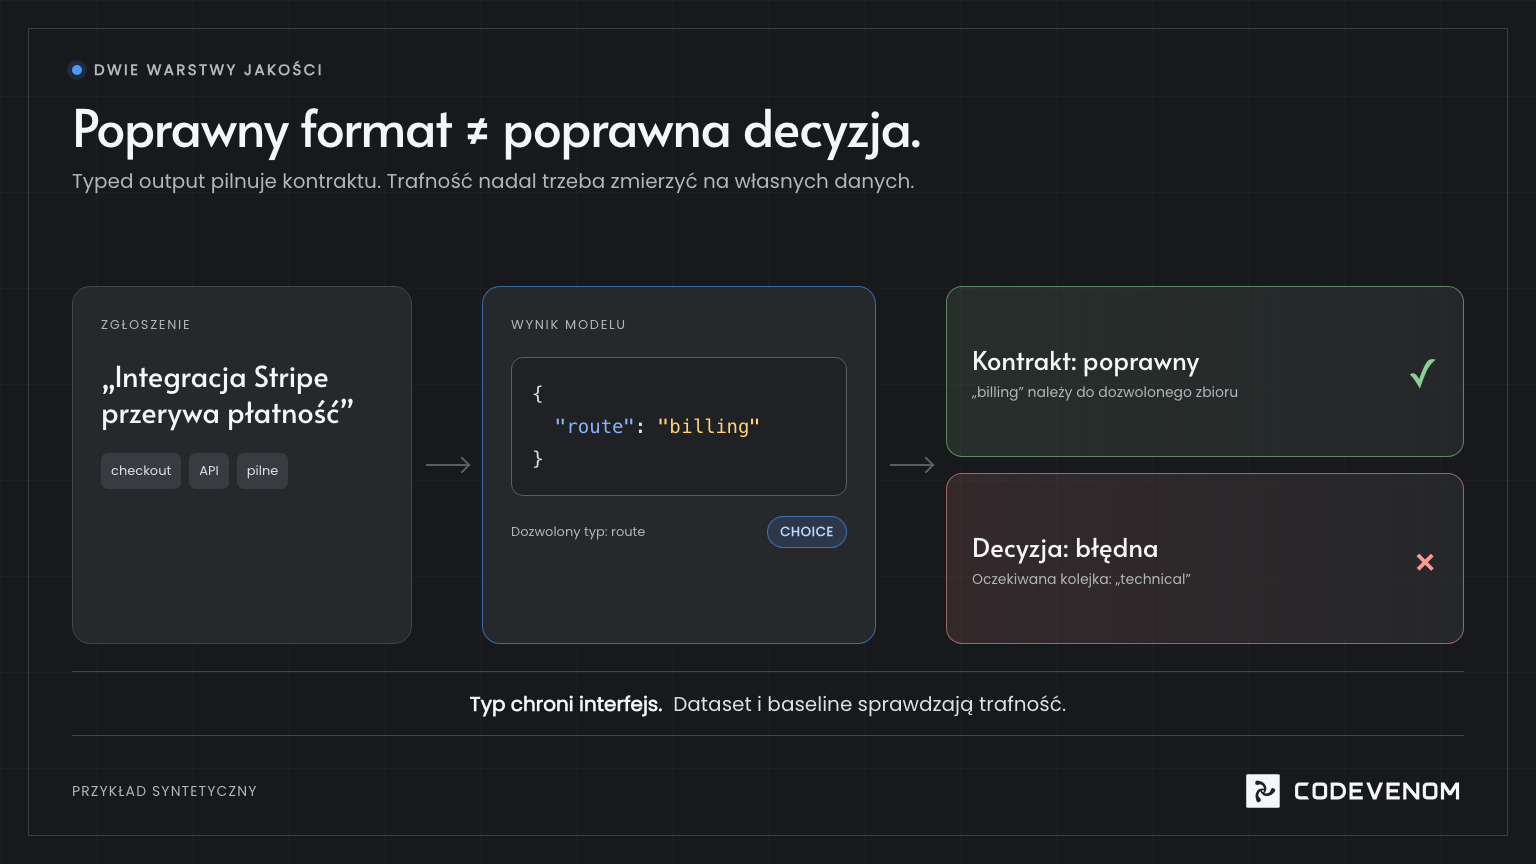
TypeSafe deklaruje brak błędów typu i używa sformułowania „can’t hallucinate”. Ten claim trzeba czytać precyzyjnie.
Jeżeli Choice dopuszcza trzy wartości, odpowiedź nie powinna nagle zawierać czwartej, nieznanej aplikacji. To usuwa problem odzyskiwania wartości z dowolnie wygenerowanego tekstu. Nadal jednak model może wybrać niewłaściwą opcję z poprawnego zbioru.
Są więc dwie osobne warstwy jakości:
-
Poprawność kontraktu: czy wynik ma dozwolony typ i format?
-
Poprawność merytoryczna: czy wybrana decyzja jest właściwa dla konkretnego przypadku?
Pierwsza warstwa może być zapewniona konstrukcją interfejsu. Drugą trzeba zmierzyć na własnych danych. Nawet dokumentacja TypeSafe zaleca zaczynać od konserwatywnych progów, testować na danych z własnej domeny i zmieniać granice wraz z obserwowanymi wynikami. Opisuje też trzy zachowania systemu: automatyczne działanie przy wysokiej pewności, kontrolę lub zebranie dodatkowych danych w środku skali oraz brak automatycznej akcji przy niskiej pewności. Zobacz dokumentację confidence.
Dobrym kandydatem jest powtarzalna decyzja, której wynik można opisać skończonym zbiorem opcji albo skalą.
Przykłady:
-
przypisanie zgłoszenia do jednego z kilku zespołów;
-
ocena pilności incydentu według jawnej skali;
-
wybór kolejnego kroku w obsłudze dokumentu;
-
oznaczenie rekordu do automatycznego przetworzenia, ręcznej kontroli albo odrzucenia;
-
sprawdzenie, czy w treści występuje jedno konkretnie zdefiniowane zjawisko.
Sam format zadania nie wystarczy. Potrzebne są jeszcze dane pozwalające sprawdzić wynik, baseline oraz możliwość bezpiecznego przejęcia niepewnych przypadków przez człowieka lub dotychczasowy system.
Przykład: routing faktury
Załóżmy, że obecny proces kieruje fakturę do jednej z trzech ścieżek: zaksięguj, wstrzymaj, wyślij do kontroli. Model otrzymuje dane faktury, zamówienia i potwierdzenia dostawy. Nie wykonuje przelewu. Zwraca tylko ocenę, która ścieżka pasuje do przypadku.
To jest kandydat do testu, ponieważ:
-
opcje są znane przed wywołaniem;
-
historyczne decyzje mogą posłużyć jako zbiór porównawczy;
-
pomyłkę można wykryć przed nieodwracalną akcją;
-
niski confidence może skierować dokument do człowieka.
Gdyby ten sam model miał samodzielnie wyjaśnić kontrahentowi spór, zinterpretować niejednoznaczną umowę i zatwierdzić płatność, jeden zamknięty wybór byłby zbyt ubogim opisem problemu.
Jev nie jest naturalnym wyborem, gdy potrzebujesz:
-
stworzyć raport, wiadomość, analizę lub inną otwartą treść;
-
przeprowadzić długie, wieloetapowe rozumowanie;
-
odkryć nowe kategorie, których nie da się zdefiniować przed wywołaniem;
-
działać bez historycznych przykładów albo innego sposobu oceny jakości;
-
automatyzować rzadką i nieodwracalną decyzję bez ścieżki kontroli;
-
zastąpić niejasną politykę biznesową modelem zamiast najpierw tę politykę uporządkować.
Warto też zatrzymać test, jeśli najwięcej pracy wymaga ciągłe przepisywanie kategorii i wyjątków. Może to oznaczać, że problem nie jest stabilną decyzją, tylko zmieniającym się procesem, którego model nie naprawi.
PytanieSygnał fitSygnał no-fitCzy wynik ma zamknięty kształt?wybór, skala lub jedno pytanie tak/nieotwarta treść albo nieznana lista wynikówCzy decyzję da się ocenić?istnieją historyczne przykłady lub jasny reviewerbrak ground truth i spójnych kryteriówCzy znamy koszt pomyłki?można rozdzielić błędy i przypisać im wagę„dokładność” bez związku z konsekwencjąCzy mamy fallback?człowiek, dotychczasowa reguła lub zebranie danychkażda odpowiedź od razu uruchamia akcjęCzy proces jest powtarzalny?stan i opcje są względnie stabilnepolityka zmienia się szybciej niż testCzy istnieje baseline?reguły, obecny LLM albo decyzje człowiekabrak punktu odniesienia
Jeżeli po prawej stronie pojawiają się trzy lub cztery odpowiedzi, integracja z nowym modelem prawdopodobnie nie jest jeszcze najpilniejszym problemem.
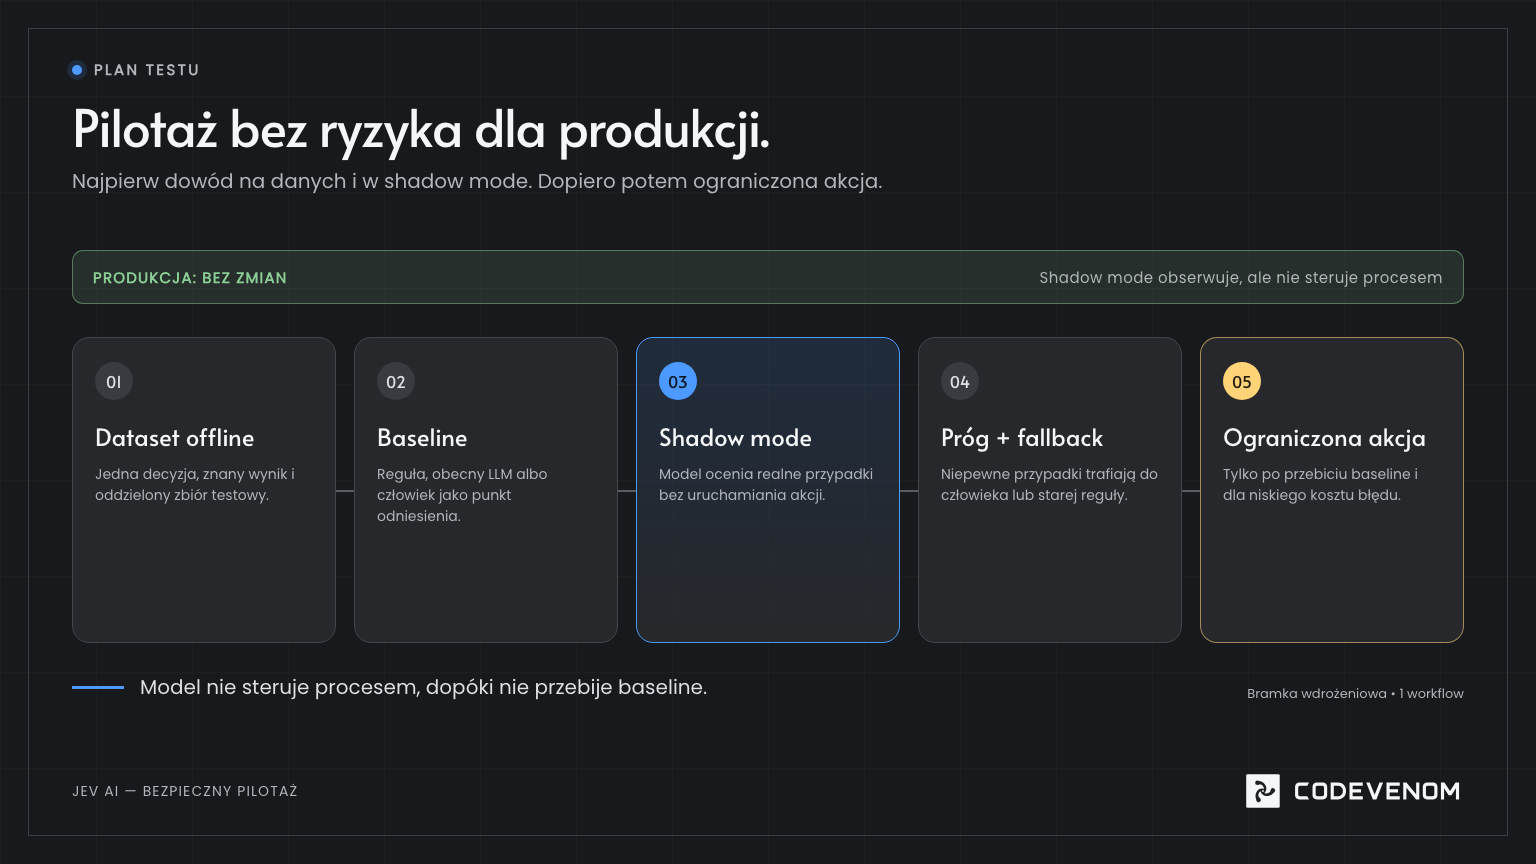
Najmniejszy użyteczny pilotaż nie powinien zaczynać się od podłączania modelu do produkcyjnej akcji.
1. Wybierz jedną decyzję
Nie „obsługa klienta”, lecz na przykład „wybór zespołu odpowiedzialnego za nowe zgłoszenie”. Jedno wejście, skończony zbiór wyników i jeden owner jakości.
2. Zamroź kontrakt testu
Zapisz strukturę state, typ pytań, opcje, reguły oraz przypadki, w których system ma odmówić automatycznego działania. Dzięki temu kolejna zmiana promptu nie zmienia po cichu definicji sukcesu.
3. Zbuduj zbiór offline
Oddziel dane używane do projektowania od danych do końcowej oceny. Usuń lub odpowiednio zabezpiecz dane wrażliwe. Każdy przykład powinien mieć oczekiwaną decyzję albo jawny status sporu między reviewerami.
4. Porównaj z baseline
Baseline może być prostą regułą, obecnym LLM, dotychczasową kolejką człowieka albo kombinacją tych rozwiązań. Bez niego nie wiadomo, czy nowy model poprawia proces, czy tylko działa inaczej.
5. Mierz błąd według skutku
Nie ograniczaj się do jednej średniej accuracy. Osobno policz pomyłki prowadzące do bezpiecznej korekty, zbędnej pracy ręcznej i kosztownej akcji. Sprawdź też jakość w przedziałach confidence, opóźnienie, koszt oraz odsetek przypadków kierowanych do review.
6. Ustal próg i fallback
Próg nie powinien pochodzić z przykładu w dokumentacji ani z intuicji. Wybierz go na podstawie własnych danych i konsekwencji błędu. Im bardziej ryzykowna akcja, tym większa potrzeba potwierdzenia albo całkowitego wyłączenia autonomii.
7. Uruchom shadow mode
Model ocenia bieżące przypadki, ale jego wynik nie steruje procesem. Porównujesz decyzję z rzeczywistym przebiegiem i obserwujesz zmianę rozkładu danych. Dopiero stabilny wynik uzasadnia ograniczony test downstream.
8. Zapisz warunek przerwania
Przerwij lub przeprojektuj pilota, jeśli model nie przebija baseline, błędy skupiają się w kosztownej klasie, odsetek review usuwa korzyść automatyzacji albo struktura procesu stale się zmienia.
Nie ma jednej odpowiedzi dla całej firmy. Jev może być sensownym kandydatem dla wąskiej decyzji, podczas gdy LLM nadal obsługuje opis, syntezę albo kontakt z człowiekiem. W innym procesie prostsza reguła if może być tańsza, bardziej przewidywalna i łatwiejsza do audytu niż oba modele.
Właściwe pytanie nie brzmi więc „Jev czy LLM?”. Brzmi: jaki wynik ma zwrócić ten konkretny etap workflow, jak ocenimy jego poprawność i co stanie się wtedy, gdy system nie jest pewny?
Szerszą macierz podziału zadań opisujemy w materiale jak wybrać model do rodzaju zadania, a warstwę kontraktów danych w przewodniku jak walidować ustrukturyzowane odpowiedzi AI.
Jeżeli masz jeden powtarzalny workflow i zastanawiasz się, czy nadaje się do takiego testu, rozpocznij projekt z CODEVENOM i opisz go w formularzu. Wystarczy decyzja, którą chcesz zautomatyzować, dostępne dane oraz koszt pomyłki. Zaczniemy od 20-minutowego przeglądu fit/no-fit: „testujemy”, „najpierw porządkujemy dane” albo „to zadanie lepiej zostawić regule, LLM lub człowiekowi”.
Czy Jev jest LLM?
TypeSafe AI przedstawia Jev jako pierwszy System One Model, czyli osobną klasę modeli przeznaczoną do decyzji wewnątrz software. Produkt nie generuje swobodnego tekstu. Przyjmuje stan i zdefiniowane pytania, a następnie zwraca typed answers, probabilities i, dla Choice oraz Score, confidence.
Czy Jev gwarantuje brak halucynacji?
Producent używa takiego sformułowania w odniesieniu do zamkniętego, typowanego wyjścia. Bezpieczniej rozdzielić brak błędu formatu od poprawności decyzji. Jev może zwrócić dozwoloną wartość, która okaże się niewłaściwa dla konkretnego przypadku. To wymaga testu na własnych danych.
Jak zacząć używać Jev?
Oficjalny quick start TypeSafe pokazuje Playground, endpoint POST /v1/systemone oraz SDK. Zanim zintegrujesz API z procesem, zdefiniuj jedno pytanie, oczekiwany typ wyniku, zbiór offline, baseline i zachowanie przy niskiej pewności.
Czy Jev działa lokalnie albo przez OpenRouter?
Takie zapytania pojawiają się w dostarczonych danych Google Trends, ale sprawdzone oficjalne materiały nie potwierdziły tych form dystrybucji. Aktualny quick start prowadzi do hostowanego API TypeSafe. Dostępność lokalną lub u zewnętrznego operatora trzeba zweryfikować bezpośrednio u producenta przed projektowaniem integracji.
Czym Jev różni się od paradoksu Jevonsa?
Jev jest nazwą produktu. Producent podaje, że wybrał ją na cześć Williama Stanleya Jevonsa i wiąże z hipotezą wzrostu użycia po spadku kosztu. Paradoks Jevonsa jest szerszą koncepcją ekonomiczną, a nie modelem AI.
-
TypeSafe AI: Introducing System One Models & Jev, 15.09.2026.
-
TypeSafe AI: Introduction, sprawdzone 24.09.2026.
-
TypeSafe AI: Primitives, sprawdzone 24.09.2026.
-
TypeSafe AI: Confidence, sprawdzone 24.09.2026.
-
TypeSafe AI: Quick start, sprawdzone 24.09.2026.