AI i automatyzacja
System One AI a LLM: które zadania oddać modelowi, a które człowiekowi?
Macierz routingu zadań: kiedy wybrać model decyzyjny, LLM lub człowieka oraz jak ustawić próg pewności i eskalację.
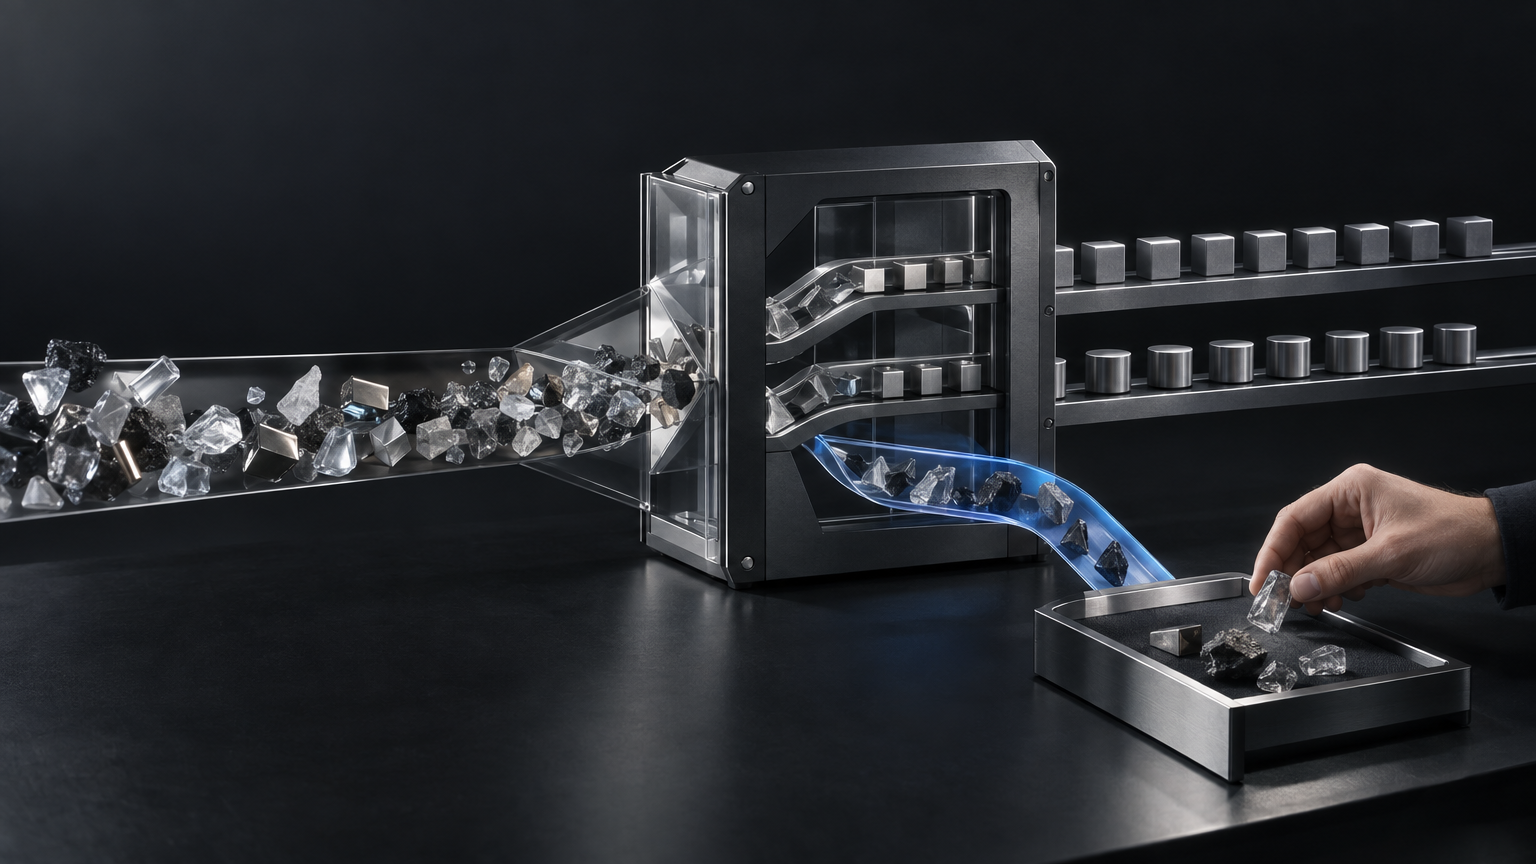
Najczęstszy błąd przy projektowaniu automatyzacji nie polega na wybraniu „złego AI”. Polega na daniu jednego narzędzia całego procesu: LLM ma klasyfikować, wyjaśniać wyjątki, pisać odpowiedź i uruchamiać akcję. To wygodne na diagramie, ale utrudnia kontrolę kosztu, błędu i odpowiedzialności.
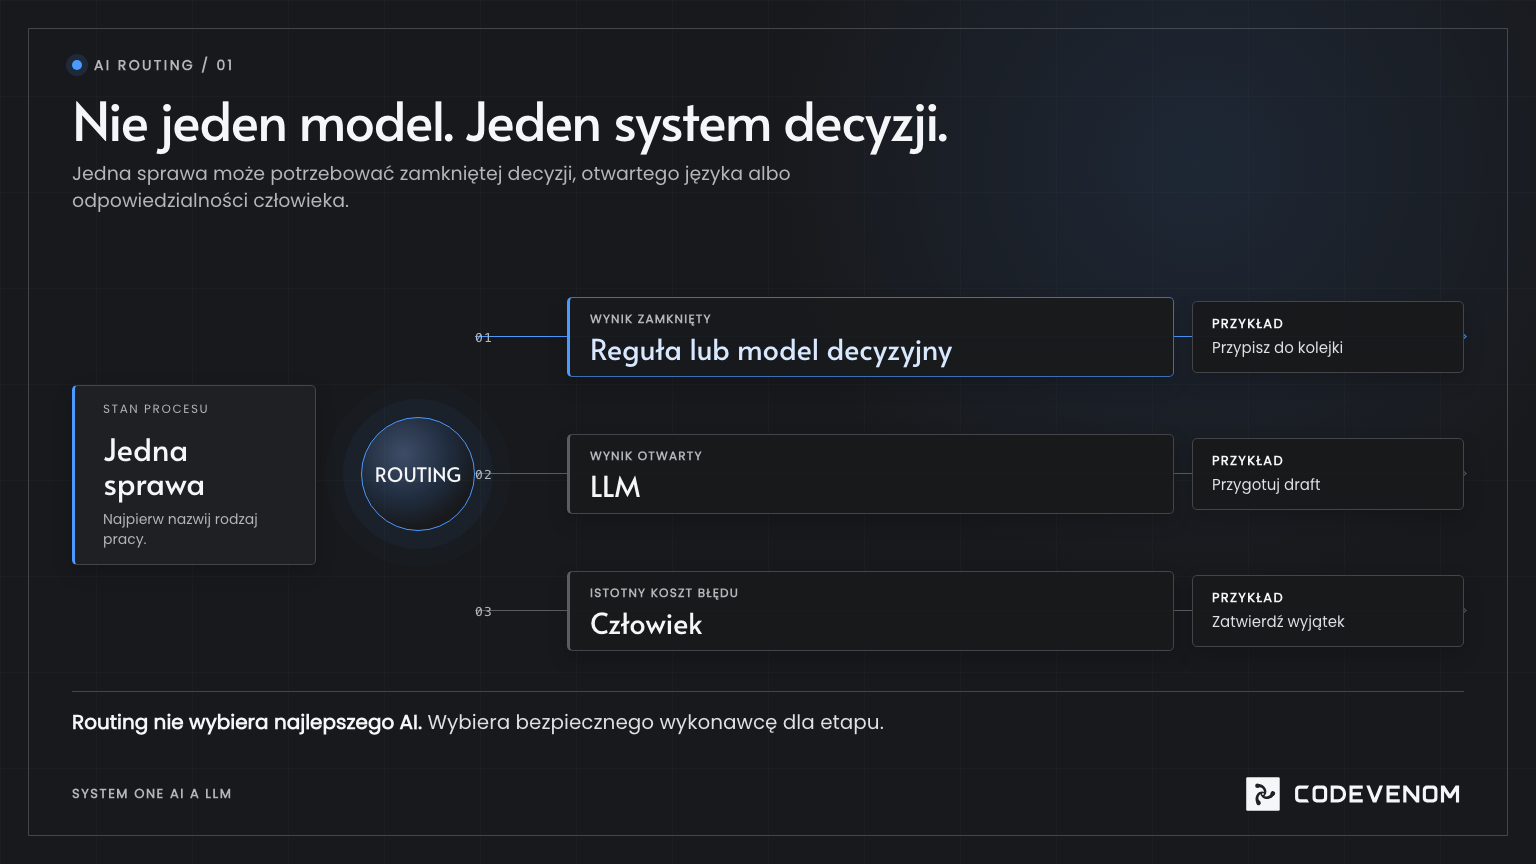
Krótka odpowiedź: zamknięte, powtarzalne decyzje kieruj do reguły lub modelu decyzyjnego; otwartą pracę na języku do LLM; a przypadki niepewne albo kosztowne w błędzie do człowieka. Próg pewności nie zwalnia z zaprojektowania tej ostatniej ścieżki.
Rodzaj etapuPrzykładDomyślny wykonawcaZamknięta decyzjaprzypisanie zgłoszenia do jednej z pięciu kolejekreguła albo model decyzyjnyOtwarty wynikstreszczenie sprawy lub szkic odpowiedziLLMWyjątek o istotnym skutkublokada płatności, zgoda na odstępstwoczłowiek z kontekstem z systemu
Ta macierz nie zastępuje oceny jakości danych ani polityki biznesowej. Pomaga natomiast nie udawać, że generowanie tekstu, wybór z listy i zatwierdzenie ryzykownej akcji są tym samym rodzajem pracy.
W tym tekście System One Models oznacza klasę modeli rozwijaną przez TypeSafe AI. Firma opisuje je jako modele do szybkich, ustrukturyzowanych decyzji wewnątrz software: wejściem jest stan i precyzyjnie zdefiniowane pytania, a wyjściem typowane decyzje oraz miary niepewności. Jev jest pierwszym publicznie ogłoszonym modelem tej klasy. TypeSafe opisuje założenia i ograniczenia swojej koncepcji w ogłoszeniu produktu.
Nazwa nawiązuje do znanego podziału na szybkie „System 1” i wolniejsze „System 2”. Nie należy jednak traktować tej metafory jak specyfikacji technicznej ani dowodu, że każda szybka decyzja automatycznie jest bezpieczna.
System One Models firmy TypeSafe AI, nie System1, Inc.
Wyniki wyszukiwania mogą mieszać ten termin z System1, Inc. To inna amerykańska spółka działająca w obszarze marketingu i pozyskiwania klientów, a nie nazwa modelu TypeSafe AI. Oficjalny profil System1 opisuje jej platformę marketingową i marki konsumenckie.
To rozróżnienie ma znaczenie praktyczne: gdy zespół sprawdza dostawcę, dokumentację albo ryzyko integracji, musi wiedzieć, o której encji mowa. W dalszej części „System One” zawsze oznacza klasę modeli TypeSafe AI.
Nie każda decyzja wymaga modelu. Zanim pojawi się prompt lub API, warto sprawdzić, czy reguła nie rozwiązuje problemu taniej i bardziej przejrzyście.
1. Reguła lub model decyzyjny: gdy wynik jest z góry ograniczony
Reguła pasuje, gdy warunek jest jednoznaczny: „jeśli kontrahent nie ma numeru zamówienia, skieruj dokument do uzupełnienia”. Model decyzyjny ma sens, gdy stan jest nieuporządkowany lub wieloczynnikowy, ale możliwe odpowiedzi nadal są skończone: kolejka A/B/C, poziom ryzyka 1–5, zaakceptuj / review / odrzuć.
Najważniejszy warunek brzmi: osoba odpowiedzialna za proces potrafi nazwać opcje i wyjaśnić, co oznacza poprawna decyzja. Model może pomóc ocenić przypadek. Nie powinien ukrywać braku polityki biznesowej.
2. LLM: gdy wartością jest praca na otwartym języku
LLM jest naturalnym wyborem, kiedy rezultat nie mieści się w ustalonej liście: trzeba streścić korespondencję, wydobyć kontekst z wielu dokumentów, przygotować roboczą odpowiedź lub zaproponować warianty.
Otwartość jest jego siłą, ale też źródłem dodatkowej pracy integracyjnej. Wynik trzeba ograniczyć kontraktem, zwalidować, a w istotnych działaniach oddzielić generowanie propozycji od jej wykonania. Artykuł o ustrukturyzowanych odpowiedziach AI w automatyzacji rozwija właśnie tę warstwę kontraktu danych.
3. Człowiek: gdy potrzebna jest odpowiedzialność, nie tylko odpowiedź
Człowiek nie jest „fallbackiem dla wszystkiego”. Powinien otrzymywać przypadki, w których koszt błędu jest wysoki, dane są sprzeczne, polityka dopuszcza wyjątek albo decyzja wymaga uprawnienia, którego system nie ma.
Dobrze zaprojektowany review nie polega na wrzucaniu człowiekowi surowej treści. System powinien przekazać proponowaną decyzję, sygnały, które do niej doprowadziły, oraz możliwe kolejne kroki. Dzięki temu człowiek zatwierdza lub koryguje konkretną propozycję, a nie odtwarza cały proces od zera.
Wybór wykonawcy można zacząć od pięciu pytań. Nie są punktacją, która automatycznie daje architekturę. Mają ujawnić, gdzie w procesie naprawdę leży ryzyko.
PytanieSygnał dla reguły lub modelu decyzyjnegoSygnał dla LLM lub człowiekaCzy wynik ma zamkniętą formę?wybór, skala, odpowiedź tak/nienowa treść, analiza albo nieznane kategorieCzy istnieje ground truth?są przykłady lub jasny reviewerkryteria są niejawne albo eksperci często się nie zgadzająIle kosztuje błąd?błąd można cofnąć lub szybko wykryćbłąd uruchamia płatność, ryzyko prawne albo relację z klientemJak pilny jest wynik?decyzja musi nastąpić w czasie procesumożna zebrać dodatkowe dane lub poczekać na reviewCzy trzeba uzasadnić decyzję?wystarczą logi wejść, opcji i regułpotrzebny jest kontekst, interpretacja lub zgoda ownera
Niepewność wyniku to nie jedyna zmienna
Ten sam poziom pewności może oznaczać różne ryzyko. Błędne przypisanie niepilnego zgłoszenia do niewłaściwej kolejki i błędne zatrzymanie płatności nie powinny mieć identycznego progu automatyzacji.
Dlatego próg warto projektować razem z konsekwencją:
-
niski koszt błędu, łatwa korekta: system może wykonać ograniczoną akcję, a wynik monitorować;
-
średni koszt albo niejednoznaczne dane: system zbiera brakującą informację, proponuje decyzję lub kieruje przypadek do review;
-
wysoki koszt, nieodwracalność albo uprawnienie: człowiek podejmuje decyzję, nawet jeśli model wskazuje wysoką pewność.
Jeśli żadna z tych ścieżek nie jest bezpieczna, problemem nie jest brak lepszego modelu. Najpierw trzeba zmienić proces lub ograniczyć akcję downstream.
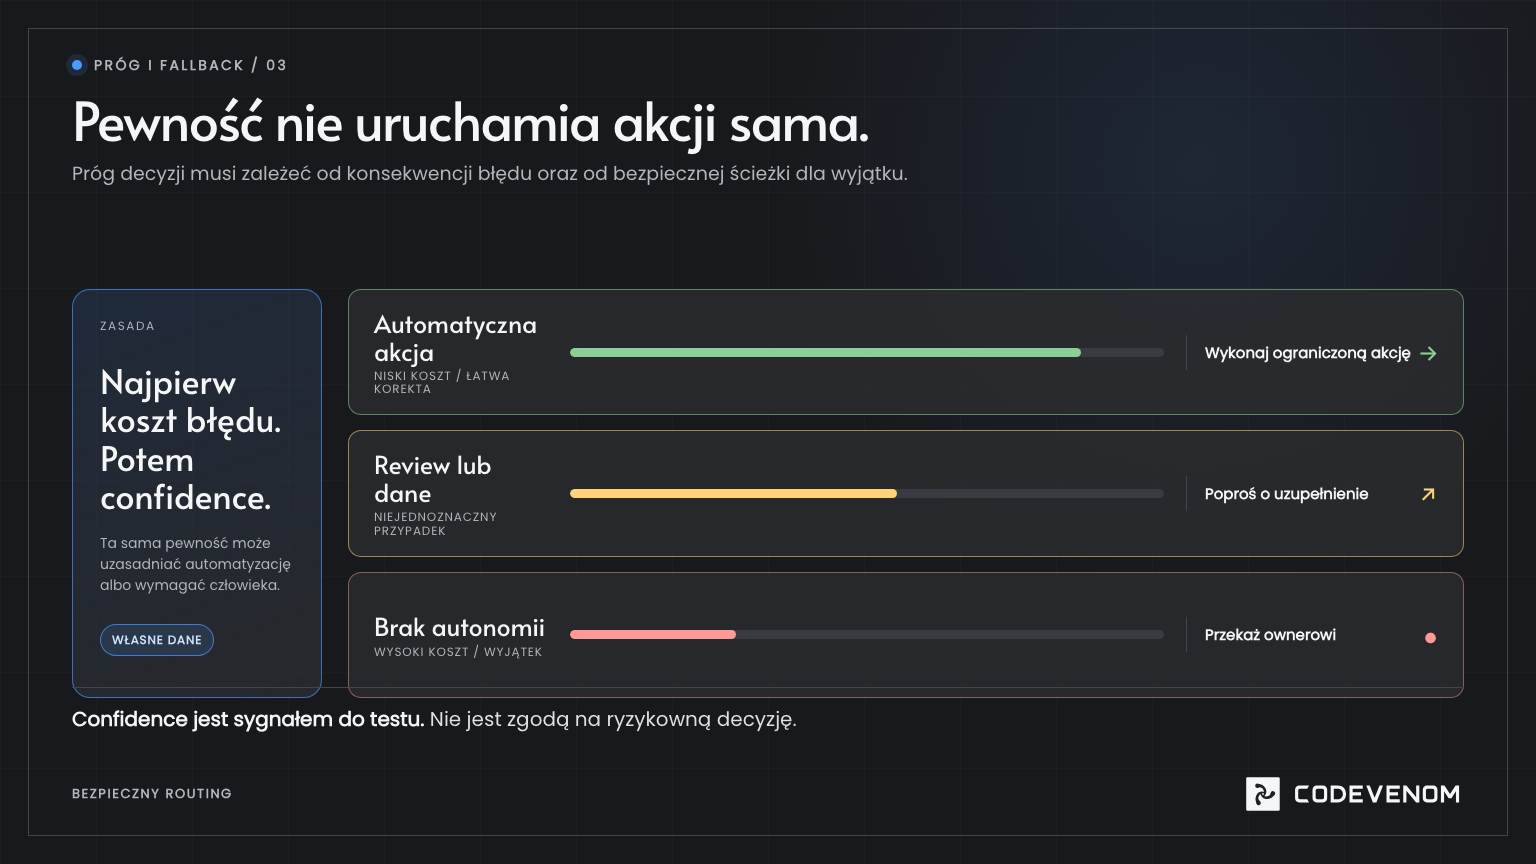
Wartość confidence nie jest obietnicą, że model „ma rację”. Jest sygnałem, który trzeba sprawdzić na własnych danych i w konkretnym typie decyzji. Ten sam poziom deklarowanej pewności może mieć inną jakość dla różnych klas spraw, języków, źródeł danych lub sezonów.
Praktyczna konfiguracja zaczyna się od trzech zakresów:
-
Automatyczna akcja: tylko dla spraw, w których wynik został wcześniej sprawdzony, a koszt pomyłki jest ograniczony.
-
Review lub dodatkowe dane: dla wyniku granicznego, sprzecznych sygnałów lub niepełnego stanu.
-
Brak automatycznej akcji: dla wyjątków, nowych kategorii i decyzji z wysoką ceną błędu.
Każdy zakres potrzebuje ownera i miernika. Mierz nie tylko średnią trafność, lecz także odsetek review, rodzaje pomyłek, czas obsługi, koszt ręcznej korekty oraz zmianę danych wejściowych. Bez tego próg staje się liczbą wpisaną do kodu na podstawie intuicji.
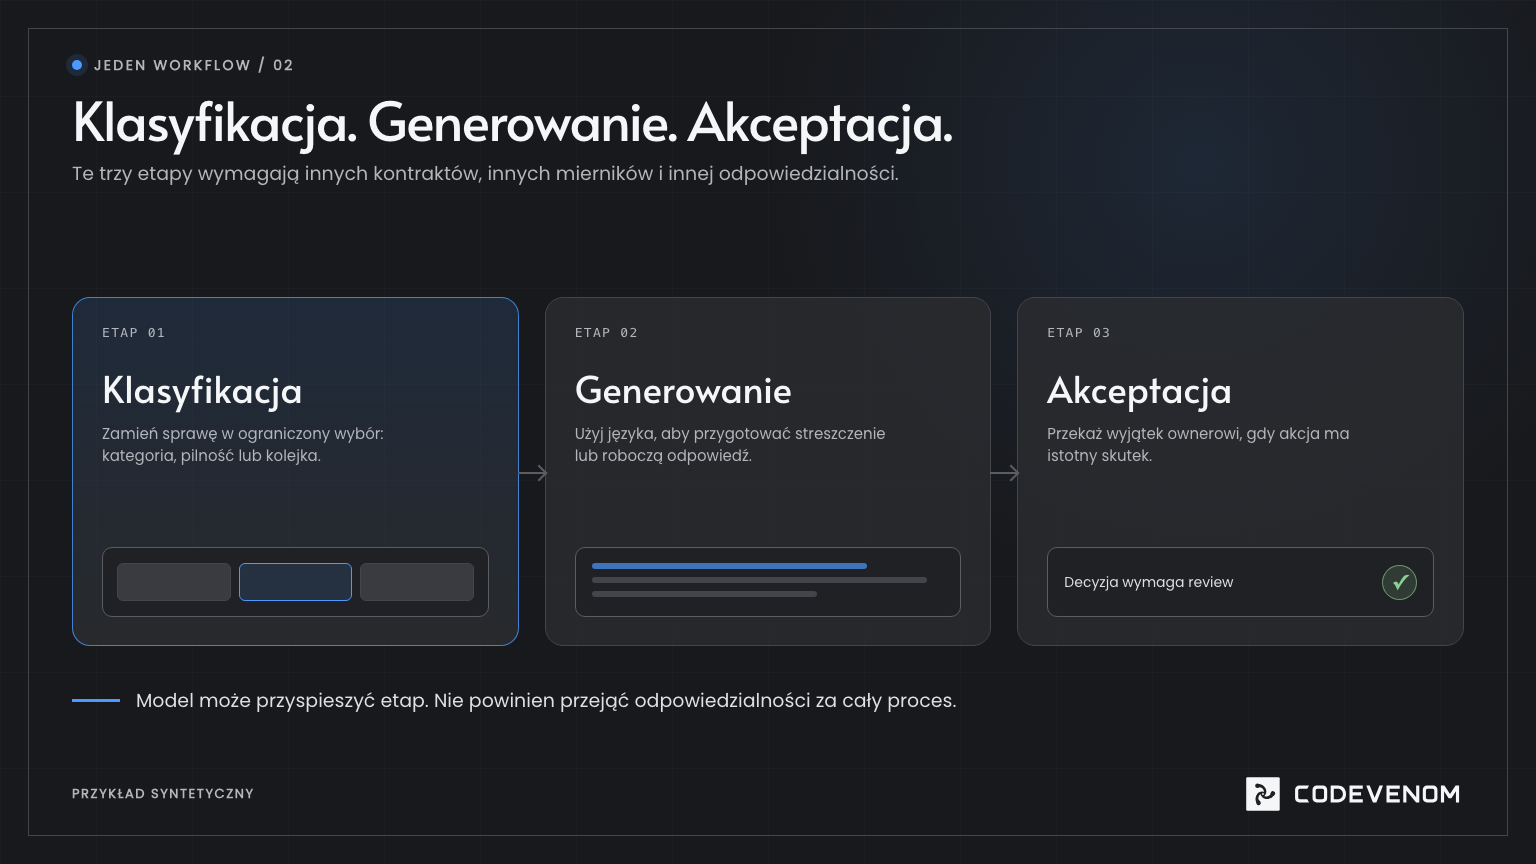
Wyobraźmy sobie nowe zgłoszenie od klienta, które może dotyczyć awarii, pytania o rozliczenie albo prośby o zmianę zakresu.
-
Klasyfikacja: reguła odrzuca sprawy bez wymaganych danych, a model decyzyjny przypisuje pozostałe do kategorii i ocenia pilność.
-
Generowanie: LLM tworzy robocze streszczenie dla opiekuna oraz szkic odpowiedzi w tonie zgodnym z polityką firmy.
-
Akceptacja: przy niskiej pewności, zmianie warunków handlowych lub ryzyku zobowiązania finansowego człowiek zatwierdza odpowiedź. Przy prostym pytaniu o status system może wysłać zatwierdzony szablon.
W tym układzie LLM nie musi udawać silnika decyzyjnego dla całego procesu, a model decyzyjny nie musi pisać wiadomości. Każdy etap ma własny kontrakt, miernik i ścieżkę korekty.
Jev firmy TypeSafe jest przykładem produktu pozycjonowanego dla pierwszej z tych klas: szybkich, typowanych decyzji. Nie wynika z tego, że jest właściwym wyborem dla każdego routingu. Najpierw trzeba sprawdzić, czy dane, opcje i koszt błędu są wystarczająco dobrze określone.
Nie zaczynaj od podłączenia modelu do akcji, której nie da się cofnąć. Najmniejszy bezpieczny krok to sklasyfikowanie 10–20 realnych zadań bez wdrażania modelu.
-
Wybierz jeden fragment workflow, a nie całe „obsługiwanie klienta”.
-
Zapisz wejście, dostępne opcje, koszt błędów i ownera decyzji.
-
Oznacz, czy sprawę obsłużyłaby reguła, model decyzyjny, LLM czy człowiek.
-
Zaznacz przypadki, w których brakuje danych albo definicji jakości.
-
Dopiero potem wybierz jedno narzędzie do testu offline lub shadow mode.
Jeżeli przy tych 10–20 przykładach zespół nie potrafi zgodnie nazwać prawidłowej decyzji, wdrożenie modelu nie jest jeszcze eksperymentem AI. Jest próbą przeniesienia niejasności procesu do software. To dobry moment, by zatrzymać lub zawęzić zakres.
Nie. System One Models firmy TypeSafe AI są propozycją dla konkretnej klasy zadań: szybkich, ustrukturyzowanych decyzji. LLM pozostaje właściwy tam, gdzie potrzebne jest rozumienie i tworzenie otwartego języka. Część zadań dalej powinna zostać prostą regułą, a część wymaga człowieka.
Właściwe pytanie brzmi więc nie „który model jest najlepszy?”, lecz: jaki wynik ma zwrócić ten etap, jak sprawdzimy jego poprawność i co stanie się, gdy system nie jest pewny?
Jeżeli chcesz rozłożyć jeden proces na te ścieżki, rozpocznij projekt z CODEVENOM. W formularzu opisz decyzję, dostępne dane i koszt pomyłki. Pierwszym rezultatem powinien być jasny wybór: testujemy routing, najpierw porządkujemy dane albo zostawiamy etap regule, LLM lub człowiekowi.
Czy System One AI to firma System1?
Nie. W tym artykule System One Models to klasa modeli TypeSafe AI. System1, Inc. jest odrębną spółką, której profil inwestorski opisuje działalność marketingową i konsumenckie marki internetowe.
Czy model decyzyjny zastępuje LLM?
Nie. Model decyzyjny ma sens, gdy wynik jest zamknięty i można go ocenić. LLM lepiej pasuje do tworzenia, syntezy i interpretacji otwartej treści. W jednym workflow oba mogą wykonywać różne etapy.
Kiedy człowiek musi zatwierdzić wynik?
Gdy koszt błędu jest wysoki, akcja jest nieodwracalna, dane są sprzeczne, polityka dopuszcza wyjątek albo decyzja wymaga formalnego uprawnienia. Wysoka pewność modelu nie usuwa tych warunków.