Przejęcie i stabilizacja systemów
Przejęcie istniejącego systemu: jak odzyskać kontrolę bez zatrzymywania delivery
Zmiana dostawcy nie musi oznaczać zamrożenia roadmapy. Zobacz, jak przejąć działający system, ograniczyć ryzyko i utrzymać najważniejsze delivery.
Najtrudniejsze przejęcia rzadko zaczynają się od całkowitej awarii. System nadal obsługuje klientów, zespół nadal publikuje zmiany, a firma nadal ma zobowiązania zapisane w roadmapie. Jednocześnie każda kolejna modyfikacja trwa dłużej, dane przestają się zgadzać, integracje reagują w nieprzewidywalny sposób, a wiedza o tym, jak bezpiecznie wydać nową wersję, pozostaje w głowie jednej osoby albo poprzedniego dostawcy.
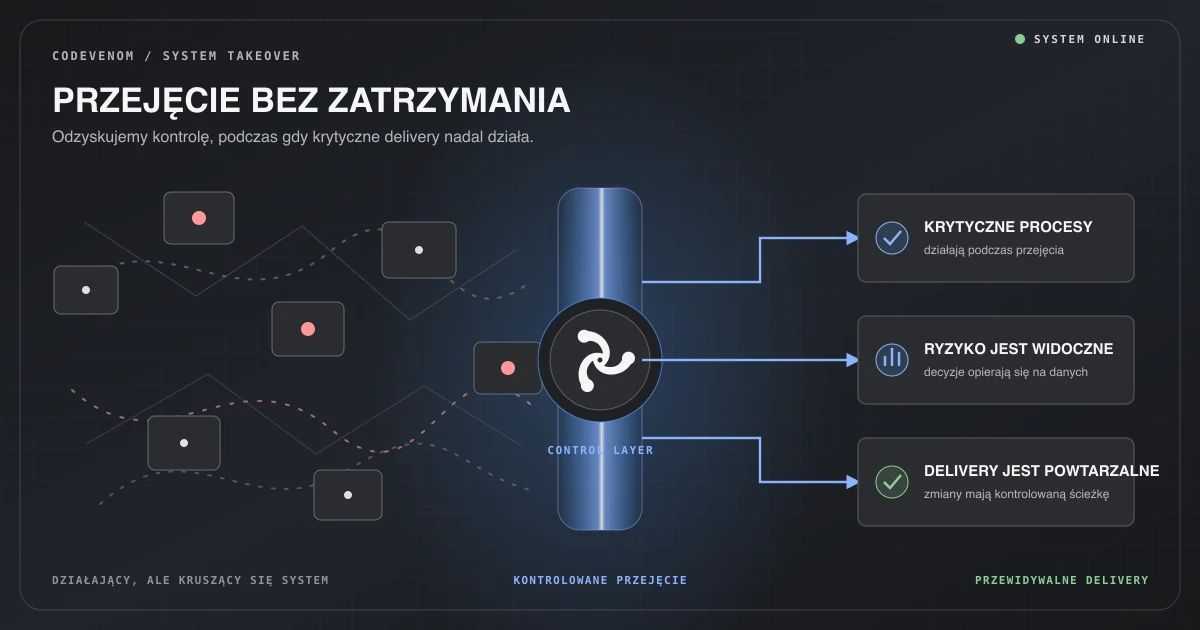
W takim momencie naturalną reakcją bywa zatrzymanie rozwoju i rozpoczęcie długiego audytu. To nie zawsze jest konieczne. Dobrze zaplanowane przejęcie prowadzi dwa tory równocześnie: chroni bieżące procesy biznesowe i stopniowo odzyskuje kontrolę nad systemem.
Ten artykuł pokazuje, co naprawdę trzeba przejąć poza kodem, jak nie zamienić stabilizacji w niekończący się remont oraz po czym zarząd może poznać, że system ponownie da się rozwijać w przewidywalny sposób.
Dostępność aplikacji nie jest jeszcze kontrolą. System może odpowiadać użytkownikom i jednocześnie pozostawać operacyjnie kruchy. Różnica ujawnia się dopiero wtedy, gdy trzeba coś zmienić, wydać albo naprawić pod presją czasu.
Firma ma kontrolę nad systemem, jeśli potrafi odpowiedzieć na kilka prostych pytań:
-
Jak dokładnie zmiana trafia na produkcję i jak można ją bezpiecznie wycofać?
-
Które procesy biznesowe są krytyczne i co je dziś chroni?
-
Gdzie znajduje się źródło prawdy dla najważniejszych danych?
-
Co stanie się z procesem, gdy jedna z zewnętrznych integracji przestanie odpowiadać?
-
Kto podejmuje decyzję, kiedy zachowanie systemu nie odpowiada już bieżącej regule biznesowej?
-
Jakie ryzyko i koszt wnosi kolejna pozycja z roadmapy?
Jeżeli odpowiedź brzmi „musimy zapytać konkretną osobę”, „zobaczymy po wdrożeniu” albo „tak było od zawsze”, problemem nie jest wyłącznie dług techniczny. Problemem jest zależność biznesu od wiedzy, której organizacja nie kontroluje.
To nie znaczy, że system trzeba natychmiast przepisać. Oznacza tylko, że przed przyspieszeniem rozwoju trzeba odzyskać zdolność do podejmowania świadomych decyzji.
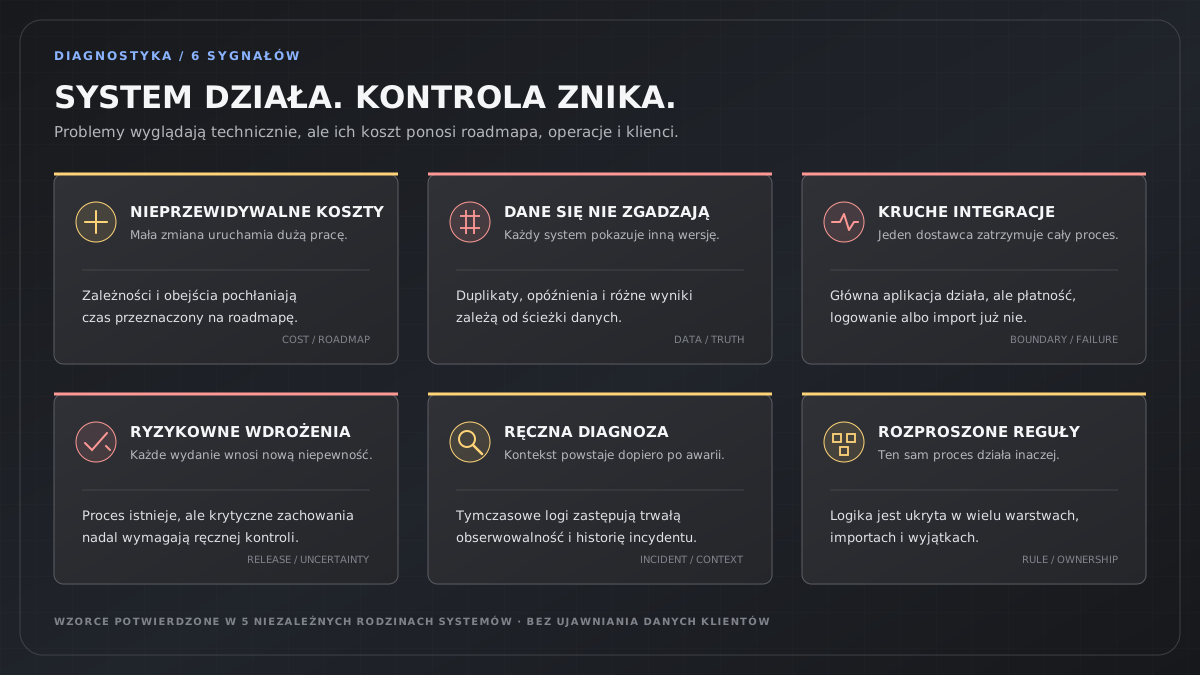
Podczas analizy pięciu niezależnych rodzin systemów powtarzały się te same klasy problemów. Różniły się branże, skala i technologie, ale konsekwencje dla firmy były zaskakująco podobne.
-
Koszt małej zmiany jest trudny do przewidzenia. Prosta funkcja uruchamia dodatkową pracę związaną ze starszymi zależnościami, buildem albo niewidocznymi powiązaniami.
-
Systemy pokazują różne wersje tych samych danych. Wynik zależy od źródła, momentu synchronizacji lub ścieżki, którą przeszła informacja.
-
Zmiana jednej integracji zatrzymuje inny proces. Główna aplikacja działa, ale płatność, logowanie, import, raport albo publikacja treści przestają przechodzić.
-
Każde wydanie wnosi nową niepewność. Zespół potrafi wdrożyć zmianę, lecz nie ma wystarczającej ochrony krytycznych zachowań i polega na ręcznej weryfikacji.
-
Diagnoza awarii wymaga dopisywania tymczasowych logów. Informacja potrzebna do zrozumienia problemu nie istnieje, dopóki ktoś nie spróbuje odtworzyć właściwego stanu.
-
Ta sama reguła działa inaczej w różnych miejscach. Logika biznesowa jest rozproszona między aplikacją, integracjami, importami i raportami.
Pojedynczy sygnał nie przesądza o potrzebie przejęcia. Jeżeli jednak kilka z nich występuje równocześnie, kolejne funkcje będą zwykle zwiększały nie tylko wartość systemu, lecz także koszt jego późniejszego uporządkowania.
Repozytorium jest jednym z elementów przekazania, ale samo w sobie nie pozwala bezpiecznie utrzymywać systemu. Kod nie wyjaśni, dlaczego część procesów działa inaczej w piątek wieczorem, które dane można ponownie przeliczyć ani z kim skontaktować się w razie odrzucenia płatności przez zewnętrznego operatora.
Pełne przejęcie obejmuje co najmniej osiem obszarów:
-
kod i historię decyzji — repozytoria, gałęzie, zależności oraz powody nietypowych rozwiązań;
-
środowiska — sposób uruchomienia systemu lokalnie, testowo i produkcyjnie;
-
wydawanie zmian — build, migracje, deployment, weryfikację i rollback;
-
dane — źródła prawdy, synchronizację, cache, importy i zasady korekt;
-
integracje — kontrakty, limity, obsługę błędów oraz zachowanie podczas niedostępności dostawcy;
-
obserwowalność — metryki, logi, alerty i kontekst potrzebny podczas incydentu;
-
reguły biznesowe — wyjątki i decyzje ukryte dziś w kodzie albo wiedzy zespołu;
-
odpowiedzialność — kto zatwierdza zmianę, kto reaguje na incydent i kto podejmuje decyzję biznesową.
Po stronie klienta nie potrzeba wielkiego komitetu wdrożeniowego. Potrzebny jest właściciel biznesowy, dostęp do osób znających krytyczne procesy oraz jasna lista zobowiązań, których nie możemy zatrzymać. To wystarcza, aby zacząć budować prawdziwy obraz systemu zamiast czekać na dokumentację, która może nigdy nie powstać.
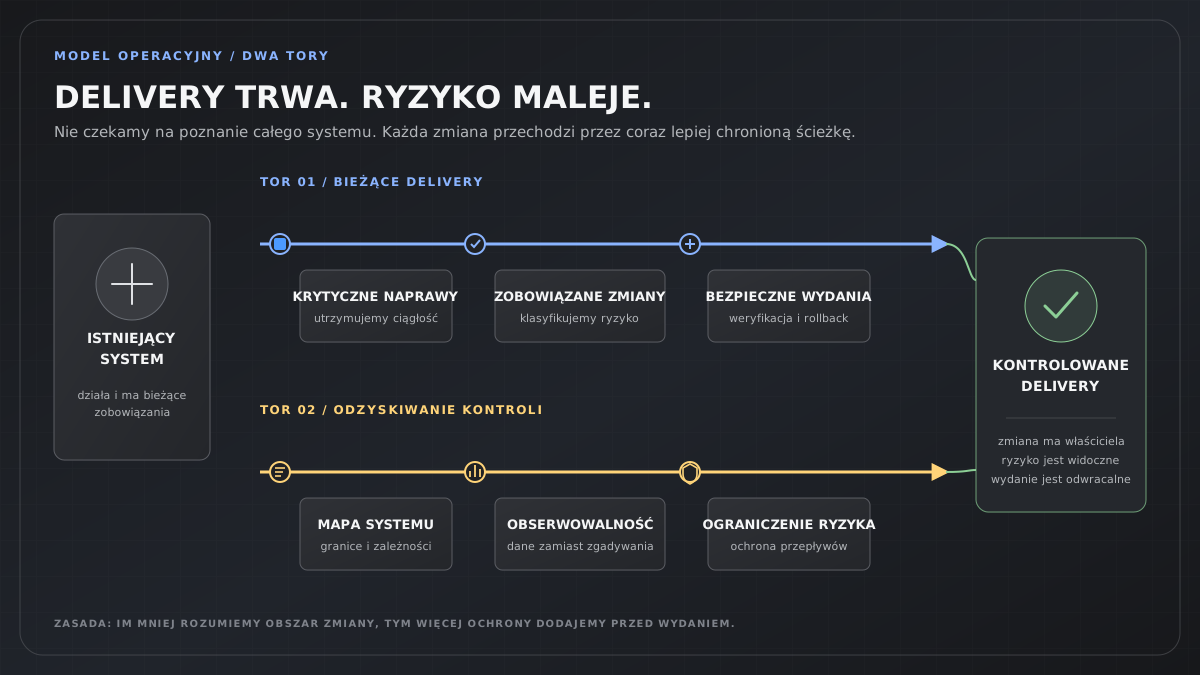
Przejęcie nie powinno automatycznie zamrażać roadmapy. Powinno natomiast zmienić sposób, w jaki zespół wybiera i wydaje zmiany. Najbezpieczniejszy model prowadzi dwa zsynchronizowane tory.
Tor pierwszy: bieżące delivery
Utrzymujemy krytyczne poprawki, zobowiązania wobec klientów i starannie wybrane elementy roadmapy. Każda zmiana otrzymuje prostą klasyfikację ryzyka: jakiego procesu dotyka, jakie dane zmienia, od których integracji zależy i jak można ją wycofać.
Tor drugi: odzyskiwanie kontroli
Równolegle budujemy mapę systemu, uruchamiamy brakującą obserwowalność, odtwarzamy proces wydawania, wskazujemy krytyczne przepływy i ograniczamy najbardziej niebezpieczne zależności. Ten tor nie konkuruje z delivery. Ma sprawić, żeby kolejne delivery wymagało mniej zgadywania.
Oba tory spotykają się przed wydaniem. Jeśli nowa funkcja przechodzi przez obszar, którego jeszcze nie rozumiemy, najpierw dokładamy potrzebną ochronę. Jeśli zmiana jest odwracalna i nie dotyka krytycznego przepływu, nie ma powodu, żeby czekała na zakończenie całej stabilizacji.
**
Celem nie jest brak zmian. Celem jest koniec zmian wykonywanych bez znajomości ich rzeczywistego wpływu.
**
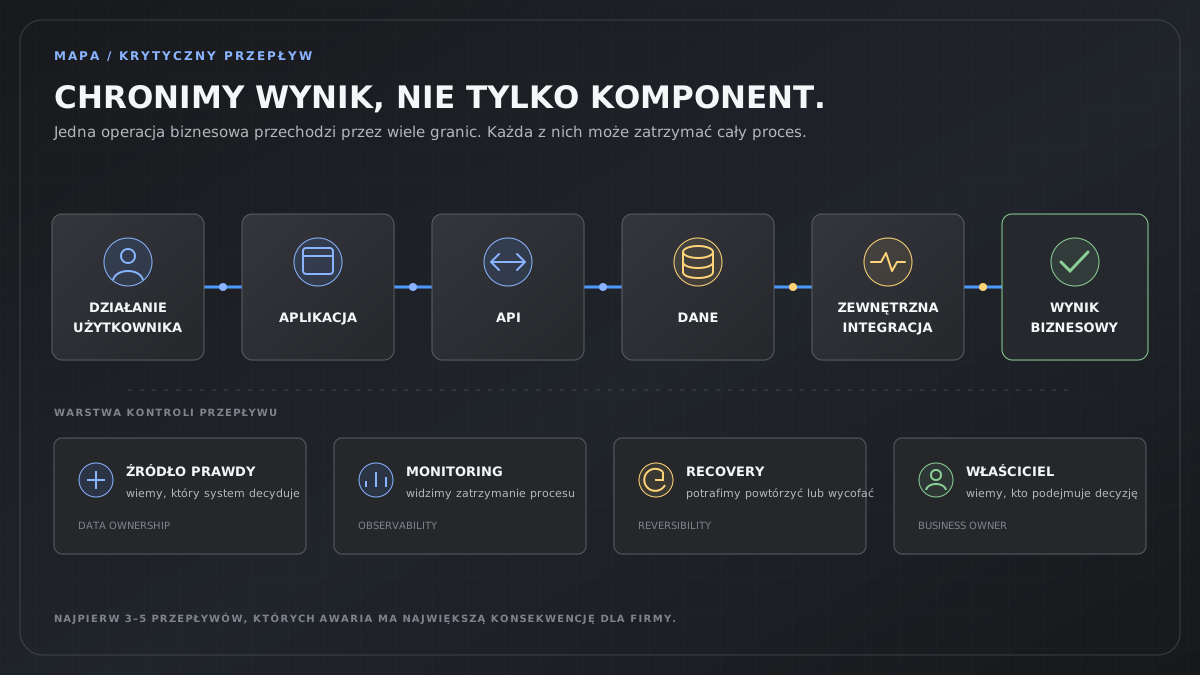
Systemy są zbudowane z komponentów, ale firma zarabia i obsługuje klientów przez przepływy. Złożenie zamówienia, przyjęcie płatności, utworzenie konta, aktualizacja uprawnienia czy przygotowanie raportu niemal zawsze przechodzą przez kilka aplikacji, baz danych i integracji.
Dlatego podczas przejęcia nie zaczynamy od pytania: „który moduł ma najwięcej długu?”. Najpierw ustalamy trzy do pięciu przepływów, których zatrzymanie miałoby największą konsekwencję dla przychodu, obsługi klienta, operacji albo rozliczeń.
Dla każdego z nich odpowiadamy na sześć pytań:
-
Co uruchamia proces i jaki wynik ma otrzymać użytkownik lub firma?
-
Przez jakie granice systemu przechodzą dane?
-
Który system jest źródłem prawdy na każdym etapie?
-
Jak rozpoznajemy, że proces zatrzymał się lub zwrócił błędny wynik?
-
Czy operację można bezpiecznie powtórzyć, skorygować albo wycofać?
-
Kto podejmuje decyzję, gdy automatyczna ścieżka nie wystarcza?
Taka mapa szybko pokazuje, gdzie naprawdę potrzebne są testy, monitoring i ochrona przed duplikacją. Dzięki temu pierwsze prace stabilizacyjne zabezpieczają wynik biznesowy, a nie tylko fragment kodu, który akurat wygląda najgorzej.
Najłatwiej zmarnować budżet przejęcia, zamieniając każdy znaleziony problem w pilne zadanie. W starszym systemie zawsze znajdzie się kod do uproszczenia, zależność do aktualizacji i proces, który można zaprojektować lepiej. Nie każdy z nich blokuje jednak bezpieczne działanie firmy.
Problemy dzielimy na pięć grup:
-
Ograniczyć teraz — ryzyko może zatrzymać krytyczny proces, zmienić dane lub uniemożliwić wydanie.
-
Uczynić widocznym — nie znamy jeszcze skali problemu, więc najpierw dokładamy pomiar i kontekst.
-
Zabezpieczyć — zachowanie jest ważne, ale można je chronić testem, walidacją, alertem albo kontrolowanym fallbackiem.
-
Zmodernizować później — obecne rozwiązanie ogranicza roadmapę, lecz ma bezpieczny okres przejściowy.
-
Świadomie zaakceptować — koszt poprawy jest dziś większy niż konsekwencja pozostawienia problemu.
Priorytet ustalamy na podstawie konsekwencji dla biznesu, prawdopodobieństwa wystąpienia, możliwości wykrycia oraz odwracalności skutków. Estetyka kodu może mieć znaczenie, ale sama nie powinna decydować o kolejności inwestycji.
Takie podejście daje zarządowi coś ważniejszego niż długa lista usterek: jasność, na jakie ryzyko wydajemy pieniądze teraz, a jakie celowo pozostawiamy na później.
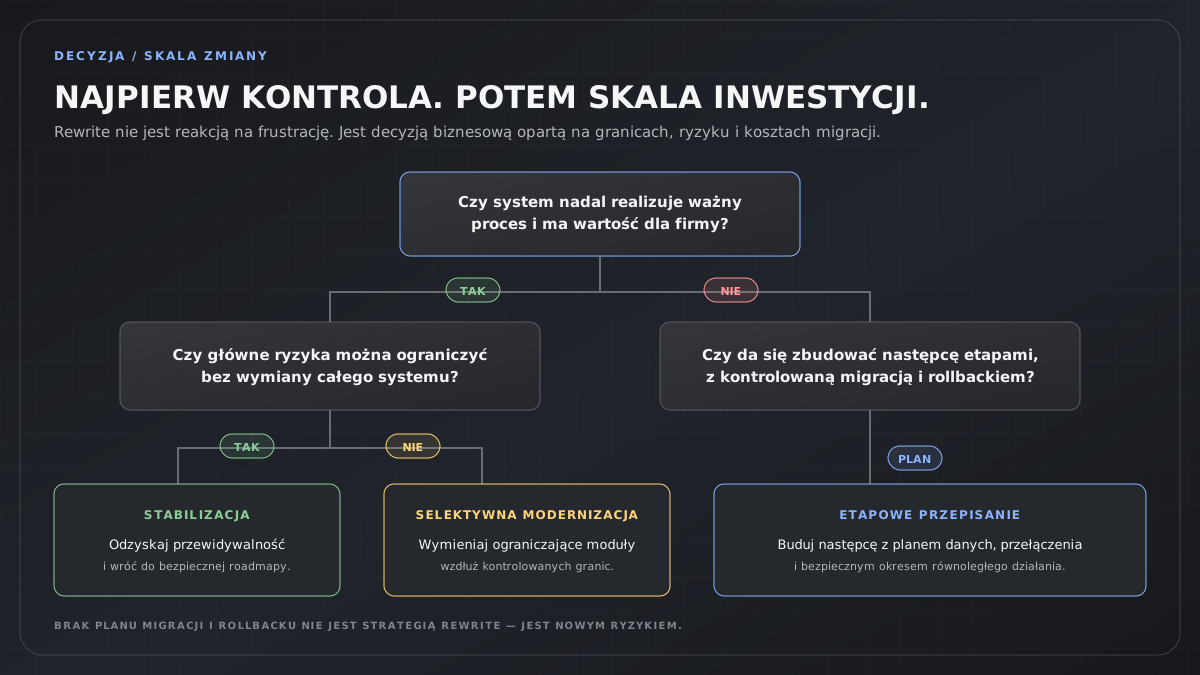
Decyzja o przepisaniu systemu często pojawia się wtedy, gdy obecny kod budzi frustrację. To zrozumiałe, ale frustracja nie jest jeszcze uzasadnieniem inwestycji. Nowy system również będzie musiał odtworzyć reguły, integracje i wyjątki, których dzisiaj nie rozumiemy.
Stabilizacja ma sens, gdy
system nadal realizuje ważne procesy, główne ryzyka można ograniczyć, a firma potrzebuje szybko odzyskać przewidywalność bez budowania wszystkiego od początku.
Selektywna modernizacja ma sens, gdy
konkretne zależności lub moduły wyraźnie blokują roadmapę, a ich granice da się oddzielić. Wtedy wymieniamy część systemu i obserwujemy efekt, zamiast uruchamiać wieloletni program transformacji.
Przepisanie może być uzasadnione, gdy
obecny model nie wspiera już sposobu działania firmy, ograniczeń nie da się rozsądnie odseparować, a organizacja potrafi bezpiecznie prowadzić migrację danych, podwójne działanie lub etapowe przełączanie użytkowników.
Najpierw odzyskujemy wiedzę i kontrolę, a dopiero potem wybieramy skalę zmiany. W przeciwnym razie nowy projekt zaczyna się od tych samych niewiadomych, które doprowadziły do problemów w poprzednim systemie.
Stabilizacja nie kończy się wtedy, gdy backlog błędów jest pusty. W działającym produkcie taki moment może nigdy nie nadejść. Kończy się wtedy, gdy zespół potrafi przewidywalnie podejmować decyzje i reagować na problemy.
Kontrola wróciła, jeśli:
-
wydanie można powtórzyć, zweryfikować i w razie potrzeby bezpiecznie wycofać;
-
krytyczne przepływy mają ochronę dopasowaną do ich rzeczywistego ryzyka;
-
najważniejsze dane mają wskazane źródło prawdy i sposób uzgadniania rozbieżności;
-
błąd integracji jest widoczny, zanim klient zgłosi jego biznesową konsekwencję;
-
incydent pozostawia trwały kontekst, a nie tylko wiedzę osoby, która go naprawiła;
-
reguły biznesowe i wyjątki mają właścicieli;
-
roadmapa uwzględnia ryzyko techniczne bez zamieniania każdego zadania w niewiadomą.
To nie jest obietnica systemu bez awarii. To zdolność do ograniczania ich wpływu, szybszego rozumienia przyczyn i podejmowania zmian bez każdorazowego zakładania najgorszego scenariusza.
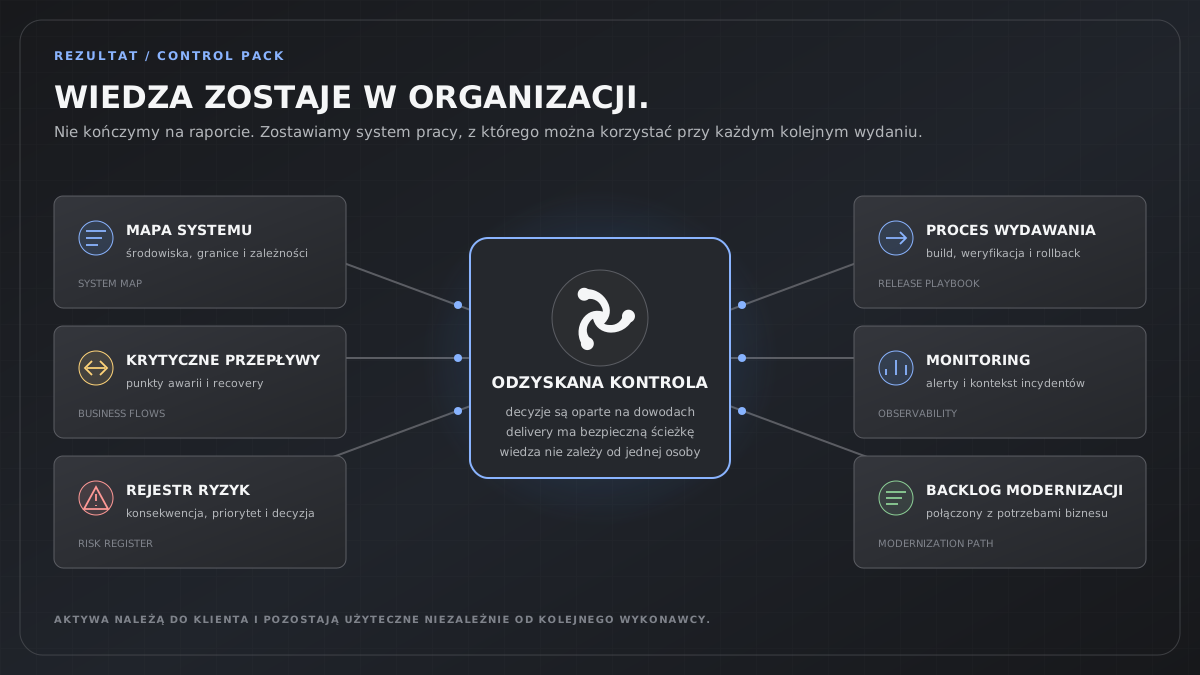
Dobry proces przejęcia nie powinien kończyć się raportem, który po prezentacji znika w katalogu. Jego rezultatem ma być sposób pracy, z którego klient i kolejni wykonawcy mogą korzystać każdego dnia.
Po przejęciu pozostają konkretne aktywa:
-
aktualna mapa systemu, środowisk i najważniejszych zależności;
-
opis krytycznych przepływów biznesowych oraz ich punktów awarii;
-
rejestr ryzyk z priorytetem, konsekwencją i decyzją dotyczącą dalszego działania;
-
sprawdzony proces budowania, wydawania, weryfikacji i wycofywania zmian;
-
monitoring najważniejszych granic systemu i kontekst potrzebny podczas incydentu;
-
uporządkowany backlog stabilizacji i modernizacji połączony z potrzebami biznesowymi;
-
jasny model odpowiedzialności za system, dane, integracje i decyzje.
To ważne również wtedy, gdy po stabilizacji klient zdecyduje się zmienić wykonawcę. Wiedza ma pozostać w organizacji i artefaktach, a nie ponownie zamknąć się w głowie konkretnego developera.
Jeżeli chcesz zobaczyć, jak CODEVENOM prowadzi taki proces, poznaj usługę Przejęcie i stabilizacja systemu.
Czy podczas przejęcia trzeba zatrzymać rozwój systemu?
Nie z definicji. Zatrzymujemy jedynie zmiany, których wpływu nie da się jeszcze bezpiecznie ocenić albo które dotykają obszaru z bezpośrednim ryzykiem dla danych i krytycznych procesów. Pozostałe delivery może działać w kontrolowanym zakresie.
Czy potrzebna jest współpraca poprzedniego dostawcy?
Pomaga skrócić drogę, ale nie może być jedynym warunkiem przejęcia. Jeśli przekazanie jest niepełne, wiedzę odtwarzamy z kodu, konfiguracji, historii zmian, środowisk, zachowania systemu oraz rozmów z osobami znającymi proces biznesowy.
Co, jeśli system nie ma aktualnej dokumentacji?
Brak dokumentacji jest częstym punktem wyjścia. Nie próbujemy od razu opisać wszystkiego. Najpierw dokumentujemy to, co jest potrzebne do bezpiecznego uruchomienia, wydania, diagnozy i ochrony krytycznych przepływów.
Ile trwa odzyskanie kontroli?
Zależy od liczby systemów, integracji, środowisk i dostępności wiedzy. Pierwsze ryzyka i plan działania powinny stać się widoczne znacznie wcześniej niż zakończenie całej modernizacji. Nie trzeba czekać na „pełne poznanie systemu”, żeby podejmować lepsze decyzje.
Czy przejęcie można wycenić z góry?
Można z góry określić zakres pierwszego etapu, sposób pracy i oczekiwane rezultaty. Wiarygodna wycena wszystkich napraw przed uzyskaniem dostępu do systemu byłaby zgadywaniem. Po zebraniu dowodów można zaplanować kolejne prace jako odrębne zamówienia, T&M albo zakres fixed price tam, gdzie niewiadome zostały ograniczone.
Czy końcowym celem zawsze jest przepisanie systemu?
Nie. Celem jest odzyskanie kontroli i dopiero na tej podstawie wybór najbardziej opłacalnej drogi. Czasem będzie nią stabilizacja, czasem wymiana konkretnego modułu, a czasem etapowe zbudowanie następcy.
Masz system, który nadal działa, ale każda kolejna zmiana kosztuje coraz więcej pewności?