Przejęcie i stabilizacja systemów
Dlaczego bugi wracają, a każda zmiana w działającym systemie trwa coraz dłużej?
System może nadal zarabiać, choć każda poprawka uruchamia kolejne testy, opóźnienia i koszty. Zobacz, dlaczego bugi wracają i co ustabilizować przed następną funkcją.
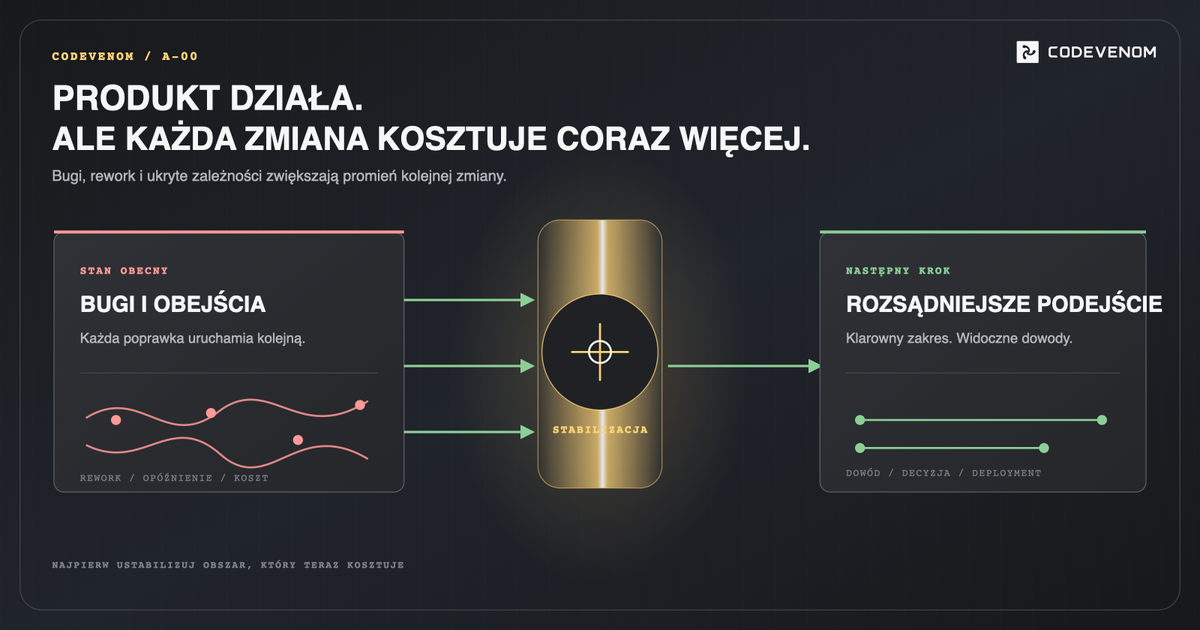
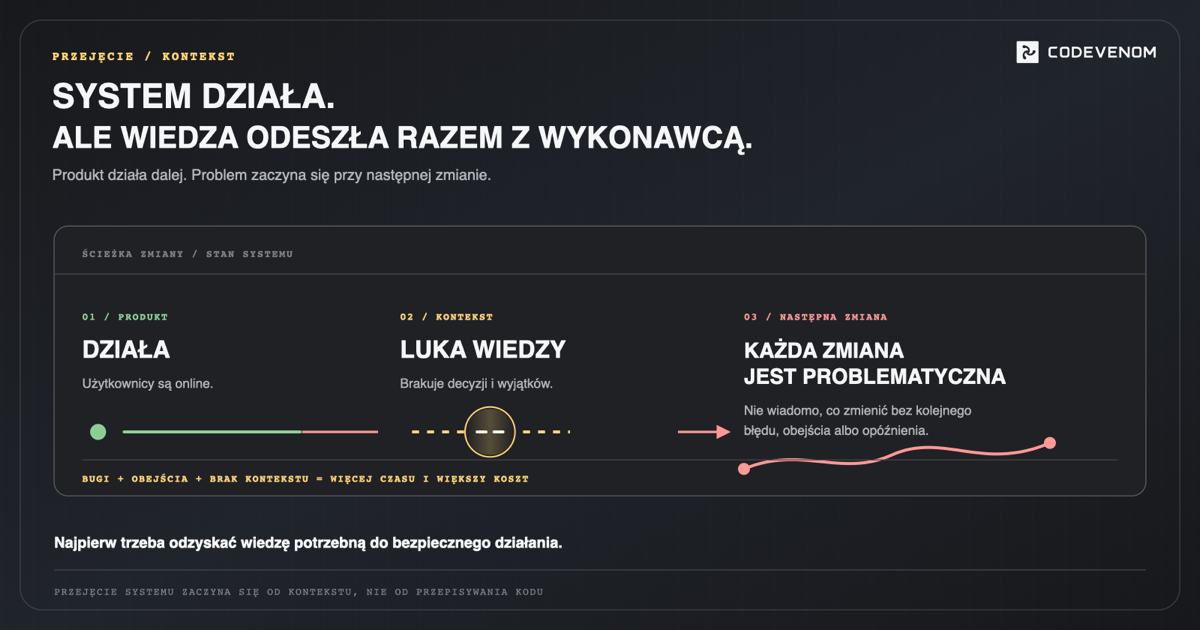
Piątek, późne popołudnie. Zadanie w Jira ma status „Done”. Poprawka działa na produkcji. W poniedziałek ten sam problem wraca, tylko w innym miejscu. To zwykle nie znaczy, że cały system trzeba przepisać. Znaczy, że naprawiono widoczny objaw, ale nie poznano całego przepływu, który ten objaw tworzy. Najpierw warto wybrać jedną zmianę generującą najwięcej reworku, prześledzić jej drogę przez dane, integracje i deployment, a potem zabezpieczyć miejsce, w którym skutek wymyka się spod kontroli.
Powracający bug jest rachunkiem wystawionym przez system za brak kontroli nad zmianą.
To zdanie jest celowo ostre. Nie każdy drugi błąd oznacza problem systemowy. Czasem błąd jest zwyczajny: ma znaną przyczynę, zamknięty zakres i oczywisty test. Poprawiasz, sprawdzasz, wdrażasz, koniec.
Problem zaczyna się wtedy, gdy słowo „koniec” przestaje cokolwiek znaczyć.
Poprawka trafia na produkcję, lecz nikt nie potrafi powiedzieć, czy obejmuje wszystkie stany danych. Test potwierdza zachowanie na ekranie, ale nie sprawdza skutku w raporcie. Integracja przyjmuje odpowiedź, ale nie wiadomo, co stanie się po ponowieniu tego samego zdarzenia. Developer zamyka zadanie zgodnie z opisem, a po kilku dniach operacje odkrywają ręczną korektę, której opis zadania nie przewidywał.
Wtedy firma nie płaci po raz drugi za tę samą linię kodu. Płaci za tę część zmiany, której wcześniej nie udało się zobaczyć, potwierdzić albo bezpiecznie odzyskać.
W małej firmie informacja o błędzie często zaczyna się od zdania, które brzmi zupełnie niewinnie:
„Klient nadal widzi zły status”. Albo: „Cena znowu nie zgadza się na jednym rynku”.
Albo: „Raport pokazuje inną kwotę niż import”.
Takie zdanie opisuje miejsce, w którym problem stał się widoczny. Nie mówi jeszcze, gdzie powstał.
Status widoczny na ekranie może być końcem sekwencji rozpoczętej przez zewnętrzny callback. Cena może pochodzić z innej ścieżki niż karta towaru otwarta przez zespół. Raport może poprawnie wykonywać swoje zapytanie na danych, które wcześniej zostały zapisane z inną precyzją albo zinterpretowane w innej strefie czasu.
To dlatego dwie osoby mogą uczciwie powiedzieć „u mnie działa” i obie mogą mieć rację. Jedna sprawdziła zachowanie komponentu. Druga zobaczyła skutek całego przepływu.
W praktyce delivery bardzo często nie zawodzi pojedyncza funkcja. Zawodzi założenie, że granica zadania pokrywa się z granicą skutku biznesowego. Zadanie kończy się na ekranie, endpointzie albo module. Skutek przechodzi dalej.
Mała zmiana staje się droga nie wtedy, gdy wymaga dużo kodu, lecz wtedy, gdy jej skutki przekraczają granice, których nikt nie potrafi sprawdzić przed deploymentem.
Najłatwiej wycenić pracę, którą widać: odtworzenie błędu, zmianę kodu, test i deployment. Znacznie trudniej zauważyć pracę uruchomioną dookoła.
Ktoś ponownie zbiera kontekst. Ktoś porównuje stare i nowe rekordy. Ktoś pyta, która wartość jest prawidłowa. Ktoś przerywa inne zadanie, bo potrzebny jest hotfix. Ktoś ręcznie naprawia dane. Ktoś tłumaczy klientowi, dlaczego poprawka nie zamknęła sprawy. Wreszcie ktoś przesuwa funkcję, która miała przynieść firmie nową wartość.
Nie wszystkie te czynności pojawią się przy każdym błędzie. Nie wszystkie znajdą się na fakturze. Każda z nich może jednak należeć do rachunku tej samej zmiany.
Można go opisać bez wymyślania uniwersalnych stawek i procentów:
koszt zmiany = implementacja + ponowna diagnoza + dodatkowe testy + korekta danych + odzyskanie po błędzie + przesunięta praca + czas decyzji
Najdroższy składnik nie zawsze jest techniczny. Dla Foundera może nim być brak odpowiedzi na proste pytanie: „Czy możemy bezpiecznie uruchomić kolejną funkcję, czy znowu otworzymy ten sam problem?”.
Jeżeli tej odpowiedzi nie ma, firma zwykle wybiera jedną z dwóch pozornie bezpiecznych dróg. Odkłada zmianę albo zamawia więcej ostrożności: kolejne spotkania, dłuższe testy, dodatkowe potwierdzenia. Obie drogi pochłaniają czas. Żadna sama z siebie nie odbudowuje kontroli.
Potrzebne jest coś bardziej konkretnego niż „zróbmy audyt” i mniej ryzykownego niż „przepiszmy wszystko”. Potrzebna jest mapa jednej zmiany.

Mapa kosztu zmiany to prosty model CODEVENOM służący do rozmowy o jednym przepływie, który wraca w postaci błędów, poprawek albo ręcznej pracy. Nie jest diagramem całej architektury. Nie próbuje udowodnić, że rozumiemy system bez dostępu do danych i kodu.
Jej zadanie jest skromniejsze i bardziej użyteczne: pokazać, gdzie kończą się fakty, zaczynają założenia i pojawia się praca, której nikt nie planował.
Mapa ma pięć pól:
WEJŚCIE -> ZMIANY STANU -> GRANICE ZEWNĘTRZNE -> WIDOCZNY SKUTEK -> ŚCIEŻKA ODZYSKANIA
1. Wejście: co naprawdę uruchamia zmianę?
„Użytkownik zapłacił” brzmi jak jedno zdarzenie. Technicznie może oznaczać kliknięcie, przekierowanie, odpowiedź operatora, callback przychodzący chwilę później i zadanie uruchomione w tle.
„Wgraliśmy plik” również nie musi być jednym zdarzeniem. Plik może zostać odczytany, zweryfikowany, przekształcony, dopasowany do istniejących rekordów i dopiero potem wykorzystany w raporcie.
Pierwsze pole mapy ma ustalić moment, od którego firma zaczyna oczekiwać skutku. Bez tego zespół może testować poprawny fragment niewłaściwego przebiegu.
Pytanie dla Foundera nie brzmi: „Który endpoint to obsługuje?”. Brzmi: „Co robi użytkownik albo operacje tuż przed tym, kiedy oczekujemy zmiany?”.
2. Zmiany stanu: co po drodze ma stać się prawdą?
System nie składa się wyłącznie z ekranów. Składa się również ze stanów, które mają znaczenie biznesowe.
Płatność jest potwierdzona. Depozyt istnieje. Saldo uwzględnia operację. Faktura ma właściwe dane. Towar ma prawidłową cenę dla wybranego rynku. Transakcja została dopasowana do właściwego identyfikatora. Raport pokazuje datę zgodnie z regułą przyjętą przez firmę.
Każde z tych zdań powinno dać się potwierdzić osobno. Jeżeli zespół potrafi wskazać tylko pierwszy i ostatni ekran, środek przepływu pozostaje założeniem.
Właśnie tam często ukrywa się rework. Pierwsza poprawka zmienia jeden stan, ale nie ustanawia reguły dla stanu, który już istniał, przyjdzie z opóźnieniem albo zostanie zapisany ponownie.
3. Granice zewnętrzne: gdzie kończy się jeden przewidywalny kontekst?
Granica zewnętrzna nie musi prowadzić poza firmę. To każde miejsce, w którym jedna część przepływu przekazuje odpowiedzialność innej części.
Może to być operator płatności, wyszukiwarka, CMS, ERP, osobna baza, kolejka, plik CSV, mechanizm mailowy albo ręczna czynność pracownika. Na granicy mogą zmienić się format danych, kolejność zdarzeń, źródło prawdy albo znaczenie pola.
To nie znaczy, że integracje są z natury złe. Znaczy, że każda granica potrzebuje jawnej odpowiedzi na kilka pytań: co zostało przekazane, skąd wiemy, że zostało przyjęte, co dzieje się po powtórzeniu i kto rozstrzyga rozbieżność.
W projekcie z realnym ruchem nie wystarczy założenie, że zewnętrzny system „wyśle raz”. Sieć może przerwać odpowiedź. Dostawca może ponowić callback. Kolejka może dostarczyć wiadomość ponownie. Człowiek może ponownie kliknąć przycisk, bo nie zobaczył potwierdzenia. System musi wiedzieć, czy jest to druga prośba o ten sam skutek, czy nowa operacja.
4. Widoczny skutek: po czym firma poznaje, że zmiana się udała?
Odpowiedź techniczna i odpowiedź biznesowa często nie są tym samym.
„Serwer zwrócił kod sukcesu” nie oznacza jeszcze, że saldo jest zgodne. „Import zakończony” nie oznacza, że raport zinterpretuje kwotę i datę tak samo. „Cena zapisana” nie oznacza, że wyszukiwarka pokaże ją dla właściwego rynku.
Widoczny skutek powinien opisywać stan, który rozpoznaje użytkownik albo osoba prowadząca operacje. Dzięki temu test nie kończy się zbyt wcześnie.
To pole chroni też przed naprawą czegoś, co technicznie wygląda podejrzanie, ale nie ma znaczenia dla aktualnej decyzji firmy. Mapa nie jest zaproszeniem do poprawiania wszystkiego. Ma pomóc połączyć pracę techniczną z konkretnym skutkiem.
5. Ścieżka odzyskania: co robimy, kiedy przepływ zatrzyma się w połowie?
To pole najczęściej odróżnia system, który działa, od systemu, który można bezpiecznie zmieniać.
Czy operację można ponowić bez podwójnego skutku? Czy wiadomo, które dane wymagają korekty? Czy błąd jest widoczny w logach w sposób pozwalający odtworzyć przebieg? Czy istnieje kontrolowany fallback? Czy deployment można wycofać bez zostawienia danych w stanie, którego poprzednia wersja nie rozumie? Czy ktoś ma prawo podjąć decyzję, gdy dwa systemy pokazują różne wartości?
Ścieżka odzyskania nie musi być rozbudowanym mechanizmem automatycznym. Czasem jest to dobrze opisana procedura i punkt kontrolny. Musi być jednak świadoma. Jeśli jedyną odpowiedzią jest „sprawdzimy ręcznie, kiedy ktoś zgłosi problem”, koszt każdego kolejnego zdarzenia pozostaje nieprzewidywalny.
Wybierz jedną zmianę. Nie moduł, nie backlog i nie „całą aplikację”. Najlepiej tę, która ostatnio uruchomiła najwięcej dodatkowej pracy albo blokuje ważną decyzję.
Przy każdym z pięciu pól zapisz trzy kolumny:
Wejście
-
Potwierdzone: Co rzeczywiście uruchamia przepływ
-
Zakładane: Co uznajemy za równoważne zdarzenie
-
Niewidoczne: Jakich wariantów nie potrafimy odtworzyć
Zmiany stanu
-
Potwierdzone: Co potwierdzają dane, logi lub test
-
Zakładane: Co wynika tylko z opisu albo pamięci
-
Niewidoczne: Których stanów nie umiemy sprawdzić
Granice zewnętrzne
-
Potwierdzone: Jaki kontrakt lub zachowanie znamy
-
Zakładane: Jakiej kolejności albo formatu się spodziewamy
-
Niewidoczne: Co dzieje się po opóźnieniu, powtórzeniu lub częściowym błędzie
Widoczny skutek
-
Potwierdzone: Co widzi użytkownik lub operacje
-
Zakładane: Co uznajemy za sukces bez pełnego sprawdzenia
-
Niewidoczne: Gdzie wynik może różnić się między ekranem, danymi i raportem
Ścieżka odzyskania
-
Potwierdzone: Co można bezpiecznie ponowić, cofnąć lub skorygować
-
Zakładane: Co zrobilibyśmy intuicyjnie
-
Niewidoczne: Kto i na jakiej podstawie podejmie decyzję
„Potwierdzone” nie oznacza „ktoś tak powiedział”. Potwierdzeniem może być test, log, rekord w bazie, konfiguracja, zachowanie odtworzone na bezpiecznym środowisku albo wynik obserwowany po kontrolowanym przebiegu.
Pamięć osoby, która zna system, jest cenna. Daje hipotezę i skraca poszukiwanie. Nadal warto sprawdzić ją w zachowaniu software'u, szczególnie jeśli dotyczy pieniędzy, stanów zamówienia, uprawnień albo danych używanych do rozliczeń.
Nie przyznawaj punktów. Nie twórz wyniku typu „system ma 63 procent kontroli”. Taka liczba wygląda profesjonalnie, ale bez wspólnej skali niczego nie rozstrzyga. Szukasz jednego miejsca, w którym brak dowodu spotyka się z wysokim skutkiem biznesowym.
Po wypełnieniu mapy zadaj trzy pytania:
-
W którym polu ostatnio powstała dodatkowa praca?
-
Która niewiadoma może ponownie zmienić wynik widoczny dla użytkownika lub firmy?
-
Jakie najmniejsze zabezpieczenie pozwoli sprawdzić następną zmianę wcześniej albo odzyskać właściwy stan po błędzie?
Odpowiedź nie zawsze będzie techniczna. Czasem brakuje decyzji o źródle prawdy. Czasem dwie części firmy używają tego samego słowa dla innych stanów. Czasem mechanizm jest poprawny, ale nie ma obserwowalności potrzebnej do odróżnienia nowego zdarzenia od powtórzenia.
Mapa działa wtedy, gdy zawęża decyzję. Jeżeli po rozmowie powstaje lista pięćdziesięciu rzeczy „do poprawy”, nie została użyta zgodnie z celem.

W anonimowej platformie płatności twórców jedno działanie użytkownika przechodziło przez operatora płatności, callback, depozyt, saldo, powiadomienie i dane fakturowe.
Na ekranie historia wygląda prosto. Użytkownik wykonuje operację. Otrzymuje potwierdzenie. Spodziewa się, że pieniądze i dokumenty będą we właściwym stanie.
Wewnątrz systemu nie jest to jedna rzecz. Zewnętrzny operator może przetwarzać płatność we własnym czasie. Callback może nadejść wtedy, gdy użytkownik nie ma już otwartej strony. Odpowiedź sieciowa może zaginąć, mimo że część operacji została wykonana. To samo zdarzenie może zostać dostarczone ponownie. Dwa procesy mogą próbować zaktualizować ten sam stan niemal równocześnie.
Jeżeli system traktuje każdy callback jak nowe polecenie, powtórzenie może stać się drugim skutkiem finansowym. Jeżeli blokada zapobiega podwójnemu wykonaniu, ale nie ma kontrolowanej ścieżki odzyskania, bezpiecznik sam może zatrzymać poprawną operację. Jeżeli status płatności zostanie skorygowany, lecz depozyt, saldo albo dane fakturowe pozostaną w poprzednim stanie, użytkownik nadal zobaczy problem, tylko w innym miejscu.
Potwierdzone prace w tym zakresie obejmowały ochronę przed wyścigiem statusów, idempotentne przetwarzanie depozytu, jawną obsługę duplikatów oraz korekty obsługi callbacków.
Idempotencja brzmi technicznie. Jej skutek jest prosty: bezpieczne ponowienie tego samego zdarzenia nie powinno tworzyć drugiego efektu, jeżeli pierwszy już nastąpił.
To jest różnica pomiędzy poprawką objawu i kontrolą zmiany. Poprawka objawu może sprawić, że komunikat na ekranie będzie prawidłowy. Kontrola zmiany wymaga odpowiedzi na pytanie, czy wszystkie istotne stany finansowe opisują tę samą operację i czy można bezpiecznie wrócić do spójności po częściowym błędzie.
Mapa kosztu zmiany dla takiej sytuacji nie zaczyna się od listy klas w kodzie. Zaczyna się od działania użytkownika. Następnie przechodzi przez stany płatności, depozytu i salda, przez granicę operatora, do wyniku widocznego dla użytkownika oraz sposobu ponowienia lub odzyskania.
Ta historia potwierdza mechanizm. Nie potwierdza kwoty uratowanych pieniędzy, spadku liczby wszystkich incydentów ani pełnego pokrycia każdego przepływu automatycznymi testami. Nie wolno z niej wyciągać wniosku, że każda integracja płatnicza ma ten sam błąd.
Pokazuje coś ważniejszego dla decyzji Foundera: prosta operacja biznesowa może mieć kilka niezależnych skutków, a każdy z nich wymaga jawnej reguły powtórzenia i odzyskania.
W anonimowym sklepie premium działającym na wielu rynkach zmiana widoczna w storefront mogła dotknąć cen, SKU, wyszukiwarki, reguł rynku, obrazów, SEO oraz zależności runtime.
Wyobraźmy sobie zwykłe zgłoszenie: jeden towar pokazuje niewłaściwą cenę w wynikach wyszukiwania. Naturalnym odruchem jest poprawienie komponentu, który tę cenę wyświetla.
Tyle że komponent może nie obliczać ceny. Może otrzymywać wynik z wyszukiwarki. Wyszukiwarka może przechowywać własny obraz katalogu. Wynik może reprezentować wariant, podczas gdy karta używa głównego SKU. Cena może zależeć od rynku wybranego wcześniej, od listy cenowej albo od fallbacku używanego wtedy, gdy odpowiedź nie zawiera pełnych danych.
Każdy fragment może być lokalnie poprawny. Razem mogą pokazywać błędny wynik, jeśli inaczej rozumieją rynek, cenę lub tożsamość towaru.
To jedna z bardziej zdradliwych sytuacji w delivery. Naprawa w warstwie widoku może wyglądać dobrze na jednym rynku i jednocześnie ukryć, że źródła nadal się rozjeżdżają. Kolejna zmiana, na przykład sortowanie, filtrowanie albo obsługa innego języka, ponownie przejdzie przez tę samą nieustaloną granicę.
Potwierdzony zakres prac obejmował uzgadnianie ścieżek cenowych, usuwanie duplikatów wyników po SKU, reguły rynku, zachowanie obrazów, SEO oraz modernizację zależności platformy.
W języku Mapy kosztu zmiany wejściem może być wybór rynku i wyszukanie towaru. Stanami są aktywny rynek, waluta, tożsamość SKU i cena możliwa do pokazania. Granicami są katalog, mechanizm wyszukiwania, middleware commerce oraz treści. Widocznym skutkiem jest właściwy wynik dla użytkownika w danym kontekście. Ścieżka odzyskania odpowiada między innymi na pytanie, co system pokaże, gdy jedno źródło nie zwróci pełnej ceny albo zwróci kilka reprezentacji tego samego SKU.
Nie mamy danych pozwalających przypisać tej pracy konkretny wzrost przychodu, konwersji czy ruchu. Nie twierdzimy też, że każda przyszła zmiana stała się przewidywalna.
Mamy natomiast potwierdzenie, że koszt widocznego błędu nie kończył się w komponencie. Znaczenie danych musiało pozostać spójne między kilkoma ścieżkami, rynkami i miejscami prezentacji.
To również wyjaśnia, dlaczego sama modernizacja biblioteki nie jest odpowiedzią na każdy powracający bug. Nowszy runtime może usunąć określone ograniczenie i zmniejszyć ryzyko utrzymania. Nie rozstrzygnie automatycznie, która cena, wersja SKU albo reguła rynku jest właściwa. Decyzje techniczne i decyzje o znaczeniu danych muszą spotkać się w tym samym przepływie.
W anonimowym portalu transakcyjnym jedna operacja przechodziła przez format CSV, interpretację kwoty, strefę czasu, dopasowanie identyfikatorów, zapytania raportowe i eksport.
Na początku jest plik. Na końcu jest raport. Pomiędzy nimi system musi odpowiedzieć na serię pytań, które wyglądają jak szczegóły techniczne, ale zmieniają wynik biznesowy.
Jaki separator został użyty w pliku? Czy nagłówek odpowiada oczekiwanemu formatowi? Czy kwota jest przechowywana jako wartość dziesiętna, czy w sposób podatny na różnice zaokrągleń? Czy data opisuje moment w UTC, czy czas lokalny? Czy identyfikator z jednego źródła odpowiada rekordowi z drugiego? Czy raport grupuje dane według tej samej reguły, której użył import?
Data i kwota nie są neutralnymi polami. Sposób ich interpretacji jest częścią reguły biznesowej.
To właśnie dlatego błąd może pojawić się daleko od miejsca, w którym powstał. Import kończy się powodzeniem, bo plik został odczytany. Problem staje się widoczny dopiero wtedy, gdy ktoś filtruje transakcje według dnia, porównuje sumę albo próbuje dopasować rekord do danych z innego źródła.
Jeżeli poprawka zmienia wyłącznie raport, może zamaskować różnicę dla jednego widoku. Jeżeli zmienia wyłącznie import, nie odpowiada na pytanie, co zrobić z historią zapisaną według starej reguły. Jeżeli poprawia dopasowanie, ale nie zapisuje jawnie stanu „dopasowano” lub „nie znaleziono”, kolejne uruchomienie może wykonać inną pracę na tych samych danych.
Potwierdzone prace w tym systemie obejmowały zgodność importu i CSV, jawne typy dziesiętne dla wartości finansowych, obsługę stref czasowych, dopasowanie identyfikatorów, filtrowanie, agregacje oraz eksporty.
Mapa kosztu zmiany pokazuje tu pełną drogę. Wejściem jest plik. Stanami są zaimportowany rekord, zinterpretowana kwota i czas oraz stan dopasowania. Granicami są format zewnętrzny, baza i logika raportowa. Widocznym skutkiem jest ten sam obraz transakcji w filtrze, podsumowaniu i eksporcie. Ścieżka odzyskania musi rozstrzygać, jak wykryć niezgodny rekord, poprawić go i uniknąć stworzenia kolejnej wersji prawdy.
Nie mamy pomiaru uptime, liczby przetworzonych transakcji, skrócenia uzgodnień ani dokładności rozliczeń. Te wartości nie mogą pojawić się jako wynik realizacji.
Potwierdzony jest mechanizm i wykonany zakres. To wystarcza, aby pokazać, dlaczego „popraw raport” bywa opisem objawu, a nie pełnej zmiany.
Badanie DORA z 2024 roku rozdziela software delivery na throughput i stability. W uproszczeniu jedno mówi, jak sprawnie zmiany docierają na produkcję i jak szybko zespół odzyskuje działanie. Drugie opisuje, jak często deployment prowadzi do niezamierzonej dodatkowej pracy.
DORA dodała do pomiaru stabilności rework rate, czyli udział nieplanowanych deploymentów wykonywanych po to, aby naprawić błąd widoczny dla użytkownika. To ważne rozróżnienie. Zespół może dostarczać zmiany, a jednocześnie wytwarzać kolejną pracę, która nie była częścią planu.
Nie należy używać tego raportu jako dowodu, że konkretny system ma problem opisany w tym artykule. DORA nie wskazuje przyczyny danego buga i nie zastępuje diagnozy. Daje natomiast język do rozdzielenia dwóch pytań: „Jak szybko dostarczamy?” oraz „Ile pracy nasze zmiany tworzą zaraz po wdrożeniu?”.
Podobnie jest z długiem technicznym. Martin Fowler opisuje dodatkowy wysiłek przy przyszłych zmianach jako odsetki płacone od słabej jakości wewnętrznej. Zwraca też uwagę, że trudny fragment software'u nie generuje takiego samego kosztu przez sam fakt istnienia. Koszt ujawnia się szczególnie wtedy, gdy trzeba go często zmieniać.
To cenna zasada decyzyjna. Nie trzeba sprzątać całego systemu. Obszar, który jest brzydki, lecz stabilny i rzadko dotykany, może pozostać bez zmian. Obszar, przez który przechodzi każda nowa funkcja, zasługuje na inną uwagę.
Mapa kosztu zmiany nie jest jednak kolejną nazwą dla długu technicznego. Dług techniczny skupia uwagę na wewnętrznej jakości software'u. Powracający koszt może również powstać na granicy danych, w zachowaniu zewnętrznego systemu, w niejawnej regule biznesowej albo w braku ścieżki odzyskania. Kod może być czytelny, a dwa źródła nadal mogą inaczej rozumieć ten sam status.
Dlatego artykuł nie prowadzi do ogólnej rekomendacji „zrób refaktor”. Prowadzi do pytania: „Którą granicę tej konkretnej zmiany musimy odzyskać, zanim dołożymy kolejną funkcję?”.

Nie każda sytuacja wymaga przejęcia systemu. Dobra decyzja zależy od tego, jak szeroki jest skutek i ile niewiadomych znajduje się na jego drodze.
Zwykła poprawka
Zwykła poprawka wystarczy, jeśli błąd jest odtwarzalny, jego granica jest znana, a sposób potwierdzenia wyniku nie budzi wątpliwości. Wiadomo, co uruchamia przepływ, które dane się zmieniają i po czym poznać sukces. Istnieje też bezpieczny sposób wdrożenia.
W takiej sytuacji rozbudowany proces byłby marnowaniem czasu. Należy poprawić błąd, sprawdzić właściwy przypadek i zamknąć zadanie.
Stabilizacja jednego przepływu
Stabilizacja ma sens, gdy błąd wraca albo zmienia miejsce, a kolejna poprawka wymaga ponownego odkrywania tych samych zależności. Szczególnie wtedy, gdy przepływ dotyka pieniędzy, zamówień, danych raportowych, uprawnień lub innej funkcji o wysokim wpływie biznesowym.
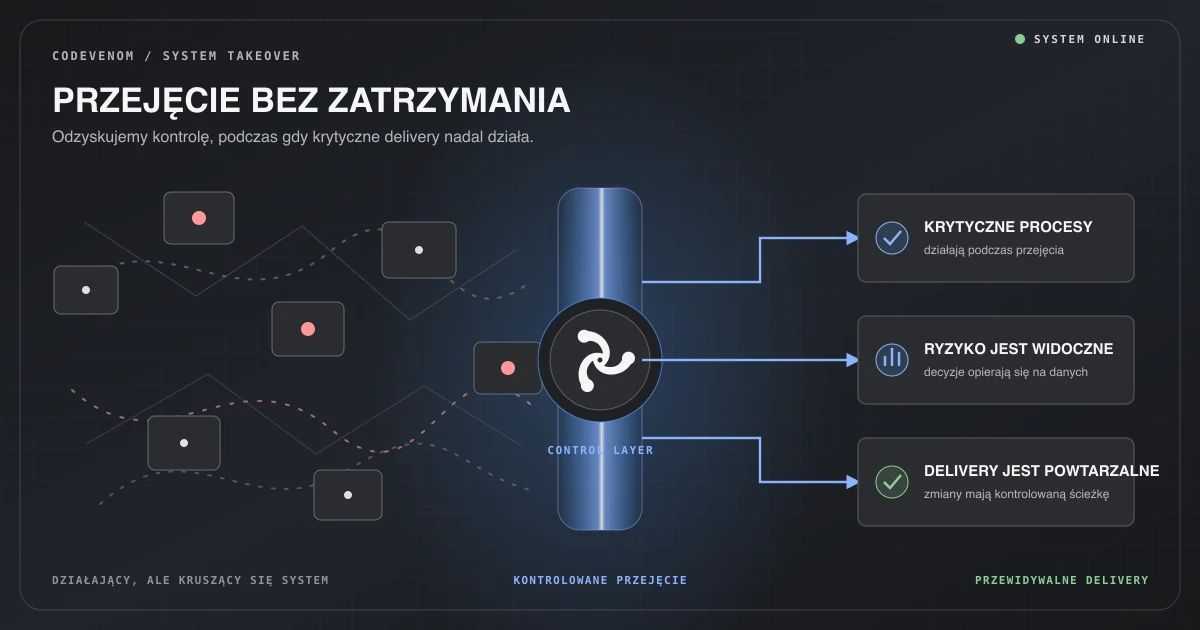
Nie oznacza poprawiania wszystkiego dookoła. Oznacza odzyskanie kontekstu potrzebnego do działania, potwierdzenie ważnych stanów, ustalenie kontraktów na granicach oraz dodanie najmniejszych zabezpieczeń potrzebnych dla następnej zmiany.
Takim zabezpieczeniem może być test krytycznego zachowania, walidacja danych, jawna obsługa powtórzenia, punkt diagnostyczny, monitoring skutku albo kontrolowana procedura odzyskania. Wybór zależy od konkretnego przepływu. Nie istnieje jeden pakiet techniczny pasujący do każdego systemu.
Selektywna modernizacja
Modernizacja jest uzasadniona, gdy konkretny komponent, biblioteka lub mechanizm blokuje bezpieczną pracę w obszarze, który firma musi regularnie zmieniać.
Słowo „selektywna” jest ważne. Aktualizacja wszystkiego tylko dlatego, że część zależności jest stara, może stworzyć większy zakres niż problem biznesowy. Z drugiej strony pozostawienie krytycznej, niewspieranej zależności w najczęściej zmienianym przepływie może utrzymywać wysoki koszt każdej następnej pracy.
Decyzja powinna łączyć częstotliwość zmian, wpływ biznesowy, ryzyko pozostawienia oraz koszt bezpiecznej migracji. Wiek technologii sam w sobie nie wystarcza.
Rewrite
Pełna przebudowa czasem jest właściwa. Nie powinna jednak być reakcją na zmęczenie kolejnym bugiem.
Nowy system musi odtworzyć reguły, dane, integracje i wyjątki starego. Jeśli nie rozumiemy ich teraz, możemy przenieść niewiadome do nowej implementacji. Zmienią się pliki i framework, ale pytania o źródło prawdy, kolejność zdarzeń oraz odzyskanie po błędzie pozostaną.
Rewrite ma sens jako decyzja ekonomiczna, gdy ograniczenia obecnego systemu blokują istotną część dalszej drogi, a selektywna stabilizacja nie daje rozsądnej ścieżki. Wymaga własnego zakresu, dowodów i porównania alternatyw. Nie jest domyślną odpowiedzią CODEVENOM.

Nie wybieraj najstarszego modułu. Nie wybieraj miejsca z największą liczbą komentarzy w kodzie. Nie zaczynaj też od tego, co najbardziej irytuje developera.
Wybierz przepływ, w którym spotykają się trzy rzeczy:
-
firma musi go ponownie zmienić albo już planuje kolejną funkcję;
-
błąd lub ręczna korekta ma widoczny skutek dla klienta, operacji albo rozliczenia;
-
obecnie brakuje dowodu, że skutek można potwierdzić lub odzyskać na całej drodze.
To miejsce ma największą szansę zwrócić wartość z odzyskanego kontekstu. Nie dlatego, że stanie się idealne, lecz dlatego, że firma przestanie za każdym razem zaczynać od tej samej niewiadomej.
Pierwszym rezultatem nie musi być duża przebudowa. Może nim być mapa potwierdzonego przepływu, naprawa jednej granicy, zabezpieczenie ponowienia i jasny test skutku. Dopiero wtedy można uczciwie ustalić, czy następna funkcja jest zwykłym zadaniem, czy otwiera kolejny obszar stabilizacji.
Ta kolejność ma znaczenie. Jeżeli najpierw dodamy funkcję, a dopiero po jej wdrożeniu zaczniemy odkrywać stany i zależności, nowy zakres sfinansuje kolejne poznawanie starego problemu. Jeżeli najpierw odzyskamy minimalną kontrolę nad zmianą, następna decyzja opiera się na dowodach.
Nie oznacza to obietnicy stałej ceny, terminu ani braku błędów. Skala zależy od systemu, dostępów, danych, integracji i kontekstu, który da się odtworzyć. Uczciwy zakres powstaje po poznaniu konkretnego przepływu.
Software Takeover & Stabilization nie jest uniwersalną odpowiedzią na każdy bug.
Nie potrzebujesz tego podejścia, jeśli masz pojedynczy, odtwarzalny błąd o znanej granicy, a obecny zespół posiada kontekst, testy i bezpieczną ścieżkę deploymentu. Zwykła realizacja zadania będzie prostsza.
Nie jest to również oferta dla firmy, której jedynym problemem jest chwilowy brak capacity. Jeżeli potrzebujesz kolejnej osoby do istniejącego zespołu, codziennego backlogu i body leasingu, szukasz innego modelu współpracy.
Podejście nie pasuje do budowy nowego systemu bez odziedziczonego kodu, danych i integracji. Tam punkt startowy oraz ryzyka są inne.
Nie należy też rozpoczynać stabilizacji, jeśli firma nie potrafi wskazać żadnego skutku biznesowego, który chce ochronić, ani udostępnić dowodów potrzebnych do sprawdzenia problemu. Bez tego powstałby otwarty audyt bez jasnej decyzji końcowej.
CODEVENOM pasuje wtedy, gdy software działa i jest potrzebny firmie, ale ważna zmiana wraca jako bug, rework albo ręczna korekta. Zaczynamy od obszaru o największym wpływie. Odzyskujemy kontekst niezbędny do działania. Ustawiamy następną zmianę na bezpieczniejszej ścieżce i kończymy jasną decyzją o dalszym zakresie.
Nie potrzebujemy na początku pełnej dokumentacji architektury. Nie potrzebujemy również listy wszystkich bugów z ostatnich lat.
Najbardziej użyteczny punkt startowy to jedna konkretna zmiana:
-
co miała zrobić;
-
jaki skutek wrócił;
-
gdzie sprawdzano wynik;
-
jaka dodatkowa praca pojawiła się po pierwszej poprawce;
-
jaka decyzja lub funkcja jest dziś przez to blokowana.
Na tej podstawie można zbudować pierwszą Mapę kosztu zmiany, określić potrzebne dostępy i oddzielić to, co potwierdzone, od tego, co nadal jest hipotezą. Dopiero wtedy ma sens rozmowa o zakresie oraz sposobie dalszej pracy.
Możesz również zobaczyć, jak pracujemy przy przejęciu i stabilizacji istniejącego systemu, oraz trzy anonimowe mechanizmy opisane w realizacjach:
Najpierw jednak nazwij jedną rzecz, która naprawdę boli. Nie „system jest stary”. Nie „kod jest trudny”. Konkretna zmiana, która miała zakończyć temat, a uruchomiła kolejną pracę.