Przejęcie i stabilizacja systemów
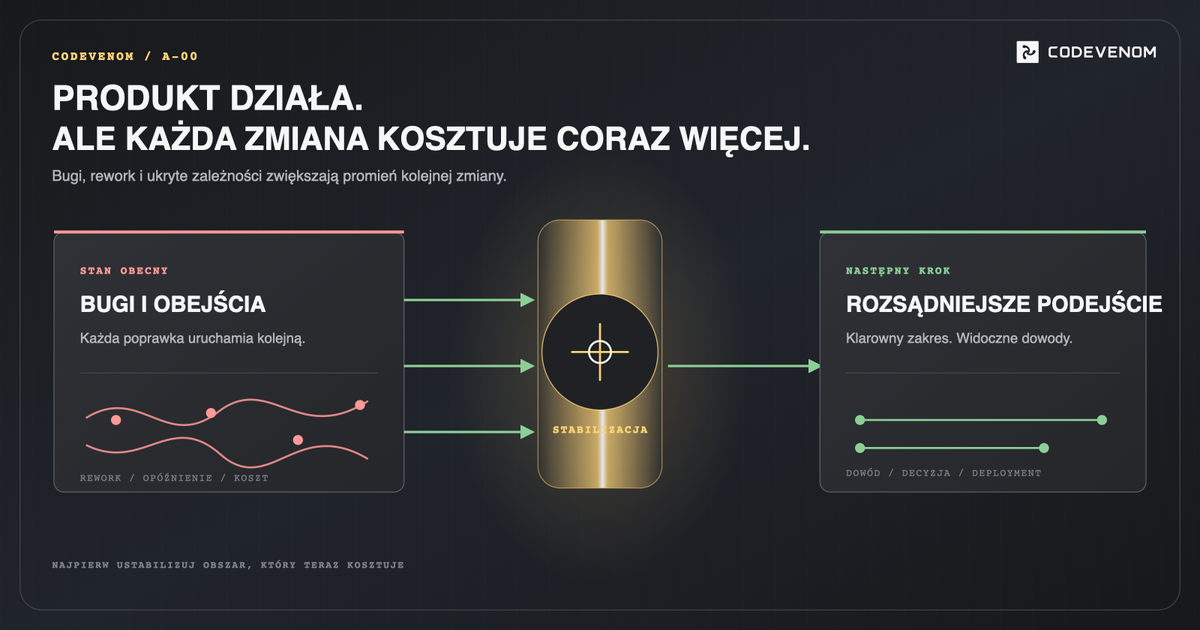
Po odejściu wykonawcy system nadal działa. Dlaczego każda zmiana zwalnia?
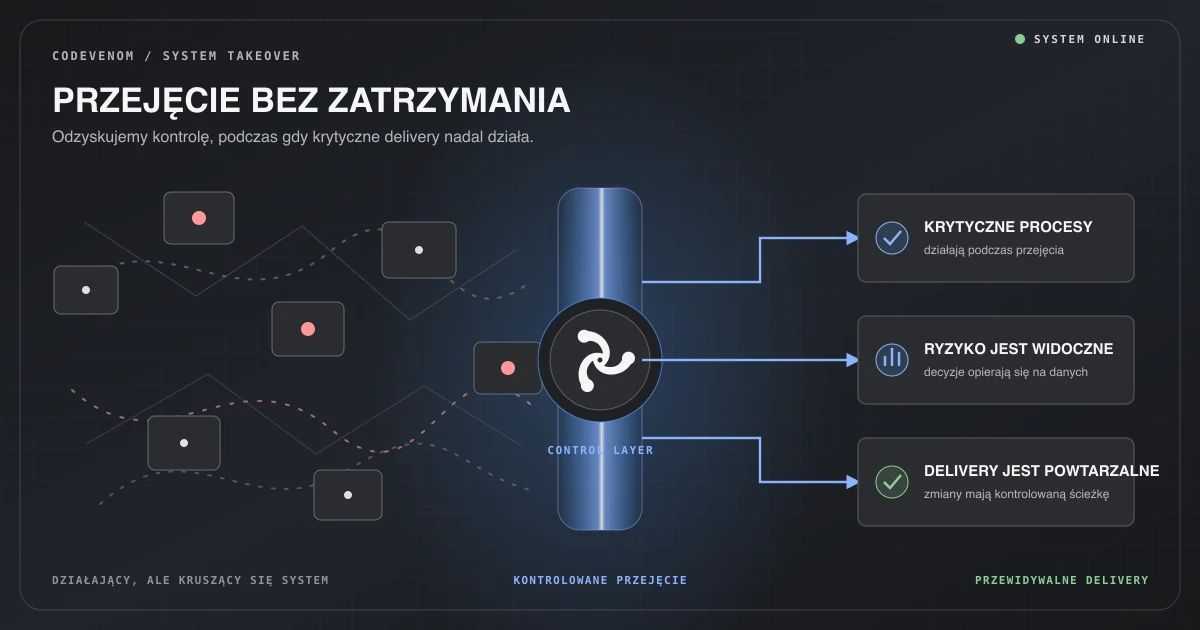
Repozytorium może zostać przekazane w jeden dzień, ale kontekst potrzebny do bezpiecznej zmiany często znika razem z wykonawcą. Zobacz, skąd bierze się spowolnienie i od czego zacząć odzyskiwanie kontroli.
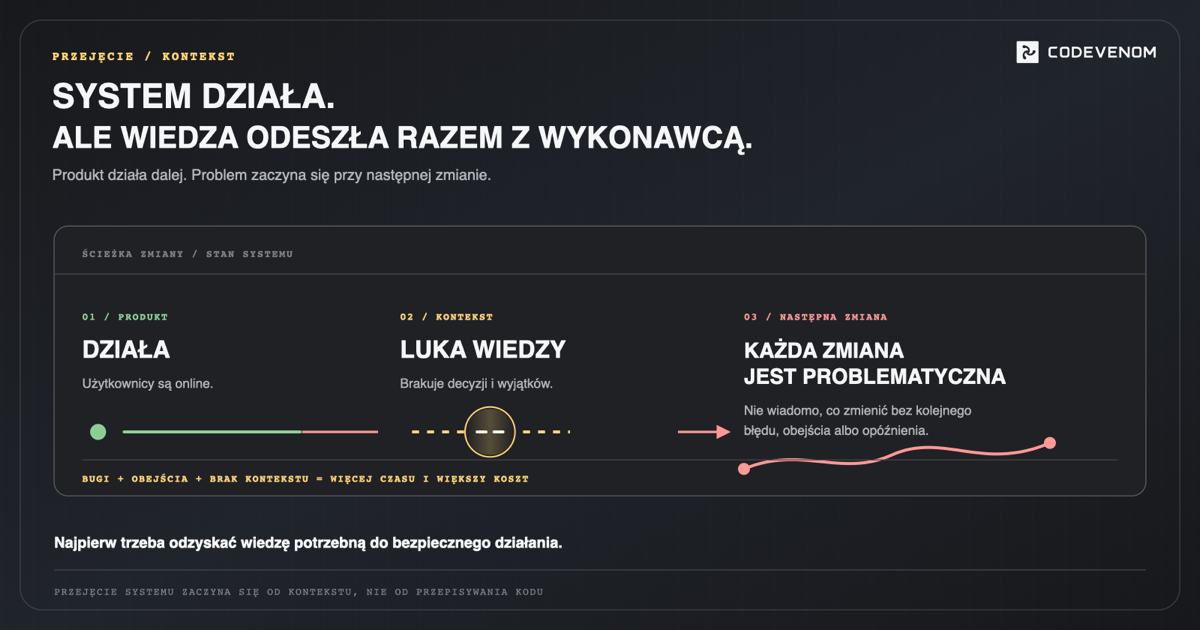
Odejście wykonawcy rzadko wyłącza produkt tego samego dnia. Użytkownicy nadal się logują, zamówienia przechodzą, a firma może nawet przez kilka tygodni nie zauważyć większego problemu. Pierwsza trudniejsza zmiana pokazuje jednak, że razem z człowiekiem zniknęła część wiedzy potrzebnej do bezpiecznego działania.
Nowa osoba dostaje dostęp do repozytorium, serwera i listy zadań. Mimo to prośba „dodajmy tę niewielką funkcję” zaczyna oznaczać długie szukanie, ręczne sprawdzanie i pytania, na które nikt nie zna pewnej odpowiedzi. System nadal działa, ale każda zmiana zwalnia.
To nie jest automatycznie dowód, że poprzedni wykonawca zrobił złą pracę. Częściej jest to skutek tego, że decyzje, wyjątki i sposób obsługi systemu pozostały w rozmowach, prywatnych notatkach albo pamięci kilku osób. W tym artykule pokazujemy, dlaczego tak się dzieje i jak podejść do pierwszego kroku bez zatrzymywania działającego produktu.
Najpierw wszystko może wyglądać normalnie. Strona działa, panel przyjmuje dane, a obsługa klienta ma swoje procedury. Potem pojawia się zadanie, które na papierze jest niewielkie: nowy typ rejestracji, zmiana sposobu naliczania opłaty albo dodatkowe pole w profilu.
Wtedy pojawiają się sygnały, że odejście wykonawcy zostawiło lukę:
-
nikt nie potrafi wskazać, który fragment systemu jest właścicielem danej reguły;
-
prosta zmiana wymaga porównania kilku modułów, tabel i integracji;
-
zespół nie wie, które zachowania są celowym wyjątkiem, a które pozostałością po starym rozwiązaniu;
-
przed deploymentem trzeba ręcznie odtwarzać scenariusze, których wcześniej pilnował konkretny wykonawca;
-
każda odpowiedź brzmi „prawdopodobnie”, więc zakres i termin zaczynają się przesuwać.
Właśnie dlatego awaria nie jest jedynym momentem, w którym firma traci kontrolę. Czasem największym sygnałem jest rosnący koszt zwykłej zmiany.
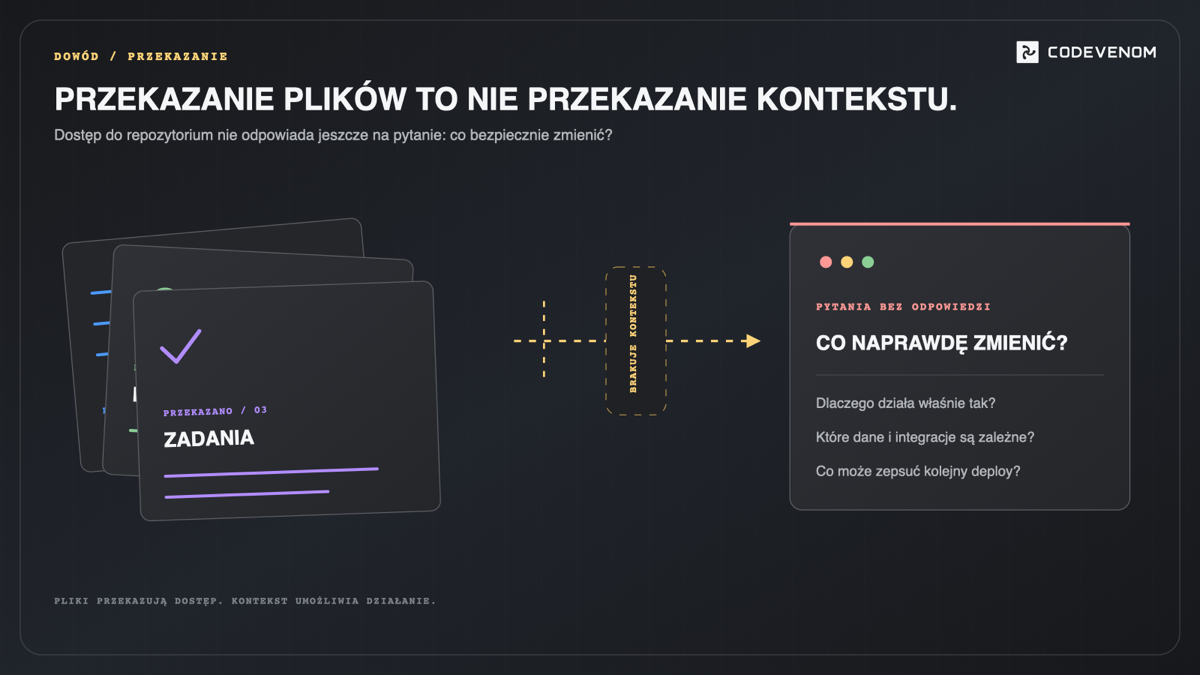
Repozytorium mówi, co system robi dziś. Nie zawsze mówi, dlaczego działa właśnie tak i czego nie wolno przypadkiem zmienić. To różnica między dostępem do plików a kontekstem potrzebnym do podjęcia decyzji.
W przekazaniu często znajdują się:
-
kod aplikacji i historia zmian;
-
dostępy do środowisk;
-
lista otwartych zadań;
-
krótka wiadomość „w razie problemu uruchom ten proces”.
Brakuje natomiast odpowiedzi na pytania, które pojawiają się podczas zmiany:
-
który system jest źródłem prawdy dla konkretnej informacji;
-
co dzieje się, gdy zewnętrzna integracja odpowiada z opóźnieniem;
-
które dane można bezpiecznie przeliczyć ponownie, a których nie wolno zdublować;
-
jak rozpoznać, że deployment zmienił zachowanie ważne dla użytkowników;
-
kto podejmuje decyzję, gdy dokumentacja, kod i proces biznesowy nie są ze sobą zgodne.
Nie chodzi o stworzenie setek stron dokumentacji. Chodzi o zapisanie minimalnego kontekstu, bez którego kolejna osoba odpowiedzialna za system musi za każdym razem zaczynać od zgadywania.
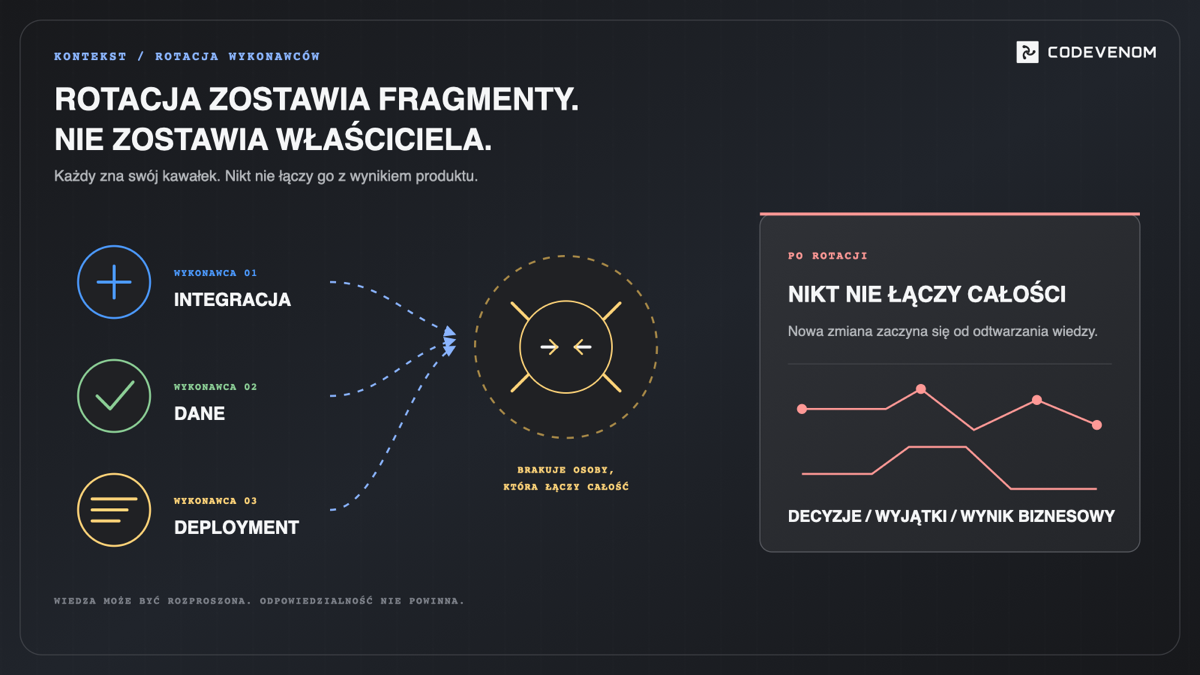
Wielu wykonawców może pracować nad jednym systemem przez lata. Każdy rozwiązuje swój fragment, ale niekoniecznie zapisuje, jak jego decyzja wpływa na resztę produktu.
Jeden dostawca zna integrację z zewnętrznym systemem. Drugi pamięta, dlaczego w bazie istnieje nietypowy status. Trzeci wie, jak wykonać deployment, ale nie zna scenariusza, który trzeba sprawdzić po wdrożeniu. Po rotacji firma zachowuje wszystkie fragmenty, lecz traci osobę, która potrafiła połączyć je w całość.
Ten wzorzec powtarzał się w dwóch anonimowych przejęciach działających produktów: oba miały użytkowników i przychód, oba rozwijało wcześniej kilka osób, a po odejściu ostatniego wykonawcy nie było jednej osoby, która znałaby cały przepływ od działania użytkownika do wyniku biznesowego. Systemy nie przestały działać. Zmienił się koszt podjęcia następnej decyzji.
Wtedy nowy wykonawca nie zaczyna od rozwoju funkcji. Najpierw musi odtworzyć historię decyzji:
-
sprawdzić, co rzeczywiście uruchamia dany przepływ;
-
porównać kod z konfiguracją i zachowaniem środowiska;
-
odnaleźć dane, które przechodzą przez granice systemu;
-
ustalić, które obejścia powstały po wcześniejszych problemach;
-
potwierdzić, jak wykonać zmianę i jak rozpoznać jej skutek.
To jest koszt rozproszonego kontekstu. Nie widać go w jednym pliku ani na jednej fakturze, ale pojawia się przy każdej kolejnej decyzji.
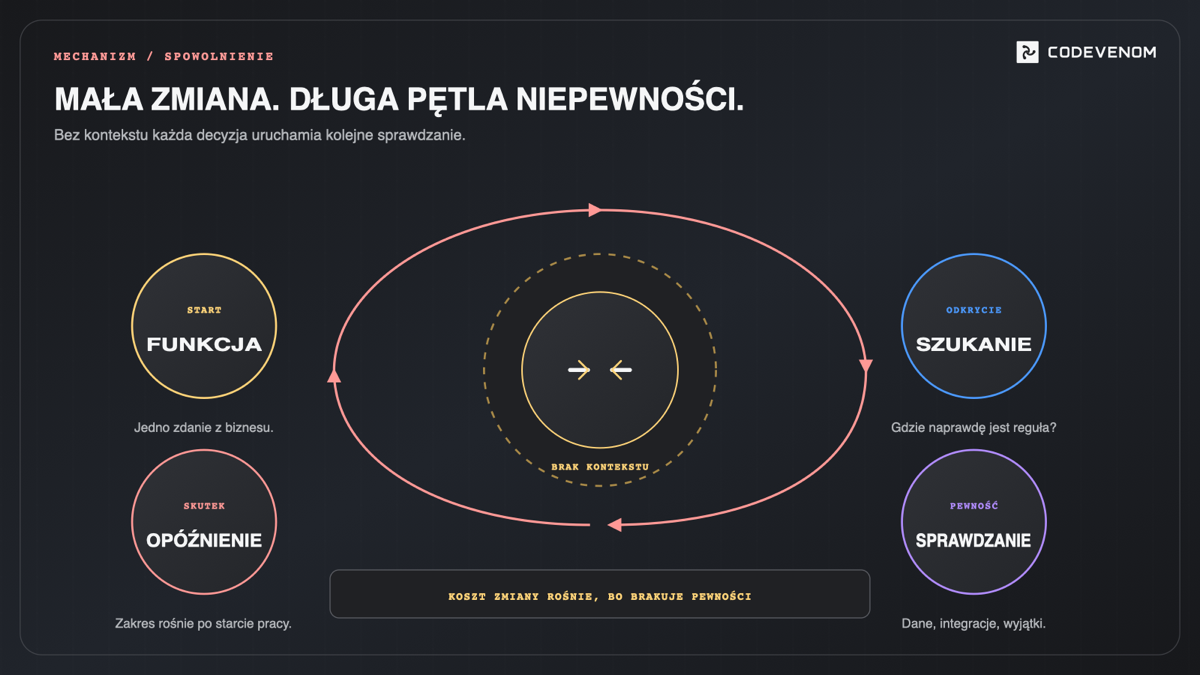
Spowolnienie zwykle nie wynika z tego, że nowy wykonawca pracuje wolniej. Wynika z dodatkowych pętli ostrożności, które trzeba wykonać, gdy nie ma pewnego obrazu systemu.
Typowy przebieg wygląda tak:
-
biznes opisuje funkcję jednym zdaniem;
-
podczas pracy okazuje się, że dotyka ona kilku miejsc, których nie było w zadaniu;
-
zmiana zostaje wstrzymana, żeby sprawdzić dane, integracje i stare wyjątki;
-
powstaje obejście, ponieważ pełna decyzja wymaga dodatkowego kontekstu;
-
testy rozszerzają się o ręczne sprawdzanie scenariuszy, których nikt nie ma zapisanych;
-
po deploymentcie trzeba potwierdzić wynik w kilku systemach.
Każda pętla ma sens z osobna. Problem w tym, że powtarzana przy większości zmian zamienia development w ostrożne śledztwo. Firma płaci za czas, który nie dostarcza nowej funkcji, tylko zmniejsza ryzyko nieznanego skutku.
Dlatego pytanie „ile godzin zajmie ta funkcja?” bywa zbyt wąskie. Warto zapytać również: „ile niewiadomych musimy rozstrzygnąć, zanim bezpiecznie zaczniemy?”.
Po odejściu wykonawcy naturalna jest chęć znalezienia osoby odpowiedzialnej za bałagan. Taka rozmowa może być potrzebna w sporze, ale nie rozwiąże problemu działającego produktu. Firma nadal musi wiedzieć, co zmienić jutro i jak nie pogorszyć sytuacji.
Lepszy punkt startu to kilka pytań o system i decyzję:
-
który przepływ biznesowy dziś najbardziej kosztuje lub blokuje rozwój;
-
co dokładnie użytkownik powinien zobaczyć po poprawce;
-
gdzie powstają dane i które systemy je wykorzystują;
-
jakie zachowanie jest potwierdzone, a co jest tylko założeniem;
-
jaki rezultat pozwoli uznać pierwszy zakres za wykonany.
Takie pytania przenoszą rozmowę z „kto to napisał?” na „co musimy wiedzieć, żeby podjąć następną decyzję?”. To ważne, gdy poprzedni wykonawca jest już niedostępny albo dokumentacja nie daje jednoznacznej odpowiedzi.
Gdy kontekst jest rozproszony, pełne przepisanie systemu może wydawać się najczystszym rozwiązaniem. Często jest jednak próbą ucieczki od niewiadomych. Nowy system także będzie musiał odtworzyć reguły biznesowe, dane, integracje i wyjątki, które dziś są słabo opisane.
Bezpieczniejszy pierwszy krok ma ograniczony cel:
-
wybrać obszar, w którym problem już wpływa na koszt, termin, obsługę lub przychód;
-
zebrać dowody z kodu, konfiguracji, danych, historii zmian i procesu deploymentu;
-
rozróżnić fakty od niewiadomych, zamiast ukrywać brak pewności;
-
ustabilizować tylko dotknięty przepływ i jego najważniejsze zabezpieczenia;
-
ustalić, jaka decyzja ma sens po zakończeniu tego zakresu.
To nie jest obietnica naprawienia całego systemu w krótkim terminie. To sposób na odzyskanie możliwości działania bez dokładania kolejnej warstwy chaosu.
Trzy reakcje wyglądają rozsądnie, ale często zwiększają koszt:
Od razu zatrudnić kolejną osobę do „robienia ticketów”
Jeśli nowa osoba nie dostanie czasu na zrozumienie zależności, będzie realizować zadania na podstawie niepełnego opisu. Tempo może chwilowo wzrosnąć, ale niewiadome zostaną przeniesione do kolejnych zmian.
Zażądać pełnej dokumentacji całego systemu
Dokumentowanie wszystkiego przed podjęciem jakiejkolwiek decyzji potrafi trwać miesiącami. W działającym produkcie lepiej zacząć od kontekstu potrzebnego dla jednego ważnego przepływu i rozszerzać go wraz z dowodami.
Przepisać wszystko od zera
Pełne przepisanie może być właściwe, ale dopiero po zrozumieniu danych, integracji i sposobu przełączenia użytkowników. Sam fakt, że system jest trudny w zmianie, nie mówi jeszcze, czy taka decyzja jest opłacalna.
Po pierwszym ograniczonym kroku system nie musi być idealny. Powinno jednak być łatwiej podjąć następną decyzję.
Firma powinna potrafić odpowiedzieć:
-
który fragment produktu został objęty pracą i gdzie są jego granice;
-
jakie dane, integracje i deploymenty wpływają na ten fragment;
-
co zostało potwierdzone dowodem, a co nadal wymaga sprawdzenia;
-
jak wykryć problem po wdrożeniu i ograniczyć jego skutki;
-
jaki jest rozsądny kolejny krok: dalsza stabilizacja, funkcja, modernizacja albo pozostawienie obszaru bez zmian.
Odzyskanie kontroli nie oznacza, że produkt przestaje mieć bugi. Oznacza, że firma przestaje płacić za każdą zmianę dodatkowym zgadywaniem.
Nie musisz od razu zamawiać pełnego audytu ani deklarować przepisywania systemu od zera. Zacznij od jednego problemu, który dziś najbardziej spowalnia firmę: powtarzającego się błędu, niedziałającej integracji, niespójnych danych, ryzykownego deploymentu albo funkcji, której nie da się bezpiecznie rozwinąć.
Na podstawie tego problemu można ustalić potrzebny dostęp, dowody rezultatu i indywidualny zakres pierwszej pracy. Dopiero potem warto decydować, czy potrzebujesz dalszej stabilizacji, modernizacji albo kolejnych funkcji.
Jeżeli system nadal działa, ale po odejściu wykonawcy każda zmiana zajmuje coraz więcej czasu, zobacz usługę Przejęcie i stabilizacja systemu albo opisz problem i rozpocznij projekt.