Development i infrastruktura
Jak wygląda postawienie środowiska staging dla istniejącej aplikacji, sklepu lub serwisu
Postawienie stagingu dla istniejącej aplikacji, sklepu albo serwisu rzadko jest prostym „kopiuj i wklej”. Zakres prac zależy od punktu startowego: czasem klient ma repozytorium i dostępy, a czasem tylko działający serwer, bez uporządkowanego procesu wdrożeń i bez gotowej infrastruktury pod środowisko testowe. W tym materiale pokazujemy, jak wygląda taki proces w CODEVENOM, czego potrzebujemy na start, jakie warianty wejścia spotykamy najczęściej i gdzie po drodze najczęściej pojawiają się schody.
Coraz częściej trafiają do nas zapytania o postawienie środowiska staging dla istniejącej aplikacji, sklepu albo serwisu. Na pierwszy rzut oka taki temat brzmi prosto, ale w praktyce prawie nigdy nie chodzi tylko o uruchomienie drugiej wersji systemu pod innym adresem. Punkt startowy bywa bardzo różny. Czasem klient ma repozytorium, dostęp do serwera i w miarę poukładany proces wdrożeń. Czasem istnieje tylko działająca produkcja, bez pełnej dokumentacji, bez bezpiecznego deployu i bez przygotowanej infrastruktury pod środowisko testowe. Dlatego zanim przejdziemy do realizacji, trzeba najpierw dobrze rozpoznać sytuację: co już istnieje, czego brakuje, jakie są zależności, z czego da się bezpiecznie odtworzyć staging i gdzie po drodze mogą pojawić się ograniczenia. W tym materiale pokazujemy, jak wygląda taki proces w CODEVENOM, czego potrzebujemy od klienta na start i jakie warianty wejścia spotykamy najczęściej.
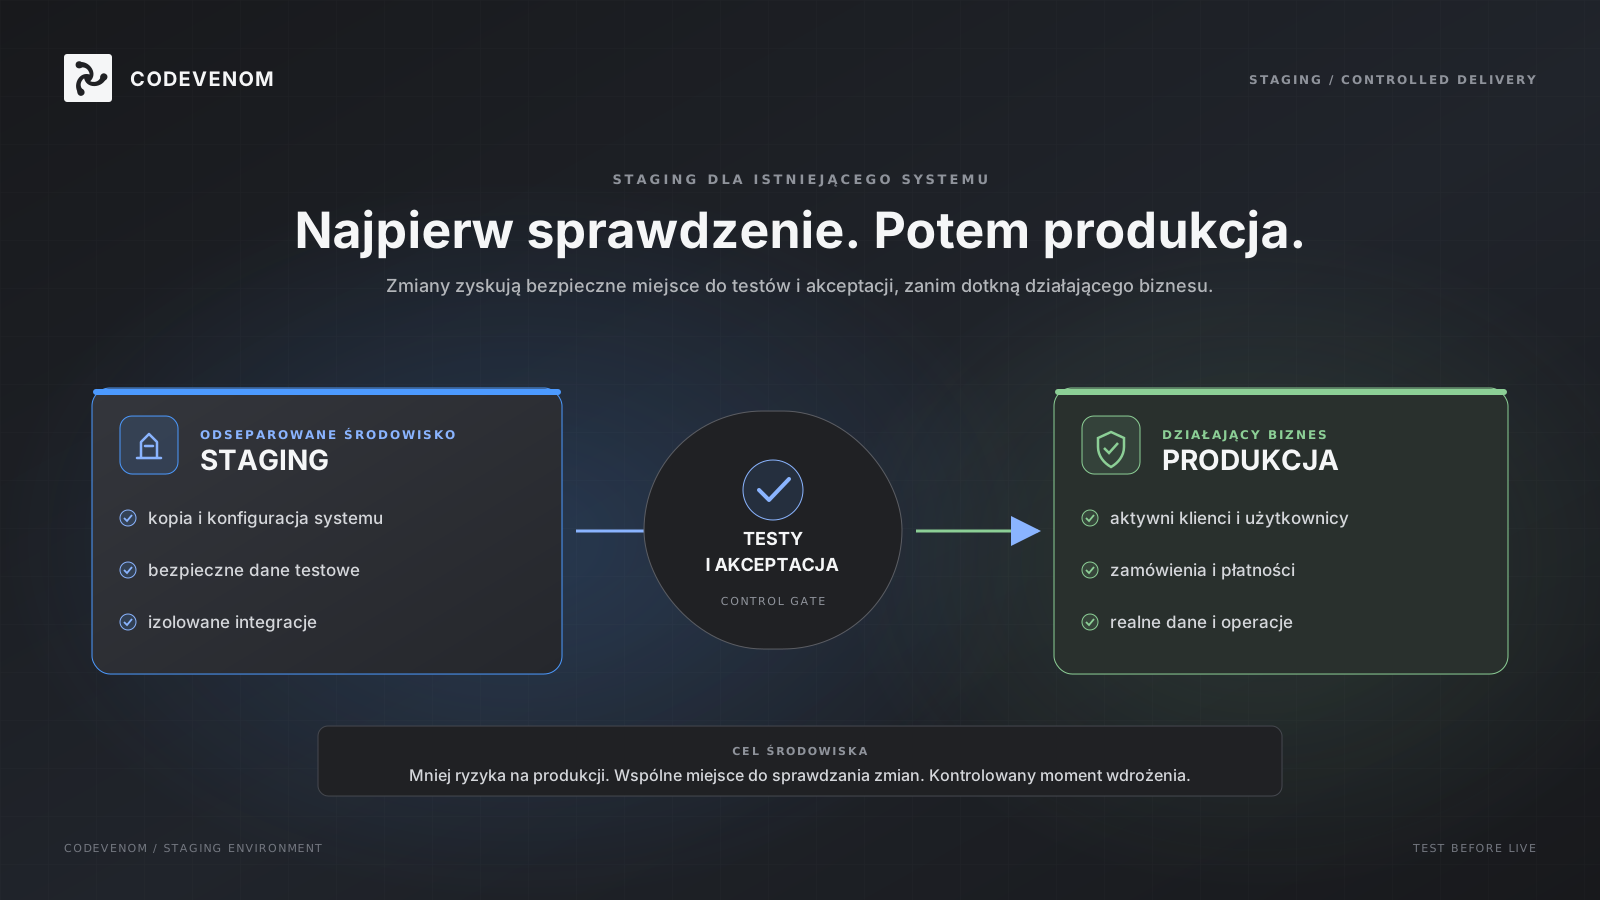
Środowisko staging dla istniejącego systemu to oddzielona kopia aplikacji, sklepu albo serwisu, która pozwala bezpiecznie testować zmiany przed wdrożeniem ich na produkcję. W najprostszym ujęciu chodzi o to, żeby zespół miał miejsce możliwie zbliżone do produkcji, ale bez ryzyka, że jedna pomyłka od razu uderzy w działający biznes, zamówienia, klientów albo dane.****
**
Problem polega na tym, że w praktyce staging bardzo rzadko oznacza po prostu „drugi serwer z tą samą aplikacją”. Żeby takie środowisko miało sens, trzeba odtworzyć nie tylko sam kod, ale też sposób uruchamiania systemu, konfigurację środowiska, połączenia z bazą danych, pliki, usługi zewnętrzne, kolejki, cron joby, integracje i zasady deployu. Dopiero wtedy staging zaczyna być realnym narzędziem do pracy, a nie atrapą, która wygląda podobnie, ale nie daje wiarygodnych testów.****
**
Dla klienta biznesowego sens stagingu jest prosty. Zamiast wprowadzać zmiany od razu na żywym organizmie, można je najpierw sprawdzić, zaakceptować i przejść przez kontrolowany proces. To ważne szczególnie wtedy, gdy system już działa, ma użytkowników, przyjmuje płatności, obsługuje zamówienia albo jest spięty z innymi narzędziami. Im bardziej istniejący system jest krytyczny dla biznesu, tym bardziej staging przestaje być wygodnym dodatkiem, a zaczyna być elementem normalnej, odpowiedzialnej pracy.****
**
W przypadku istniejących aplikacji staging ma jeszcze jedną rolę. Pomaga uporządkować wiedzę o systemie, który często był rozwijany etapami, przez różne osoby i bez pełnej dokumentacji. Już samo przygotowanie takiego środowiska pokazuje, czy projekt ma czytelny proces wdrożeniowy, czy wszystko da się odtworzyć z repozytorium, czy konfiguracja nie siedzi tylko na serwerze produkcyjnym i czy zespół rzeczywiście kontroluje sposób uruchamiania aplikacji. Bardzo często staging nie tylko daje miejsce do testów, ale też odsłania, gdzie system jest poukładany, a gdzie działa bardziej siłą rozpędu.****
**
Dlatego kiedy mówimy o postawieniu stagingu dla istniejącego systemu, nie mówimy wyłącznie o skopiowaniu aplikacji. Mówimy o zbudowaniu bezpiecznego, przewidywalnego i możliwie wiernego środowiska pracy, które pozwala rozwijać system bez zgadywania i bez niepotrzebnego ryzyka po stronie produkcji.
W większości przypadków firma nie zgłasza się po staging dlatego, że nagle chce mieć „bardziej profesjonalną infrastrukturę”. Zwykle za takim zapytaniem stoi konkretny problem operacyjny. Zmiany są już potrzebne, system działa na produkcji, a każdy kolejny deployment zaczyna być obarczony zbyt dużym ryzykiem. Ktoś boi się ruszać działającą aplikację, bo nie ma gdzie sprawdzić zmian. Ktoś inny chce najpierw pokazać nową funkcję biznesowi albo klientowi, zanim trafi ona na live. Czasem problemem są błędy pojawiające się dopiero po wdrożeniu, a czasem sam fakt, że zespół nie ma miejsca do spokojnej pracy i testów.****
**
Bardzo często staging pojawia się wtedy, gdy firma dochodzi do ściany z modelem pracy „wrzucamy od razu na produkcję i liczymy, że będzie dobrze”. Na początku taki sposób działania może jeszcze przechodzić, szczególnie przy małym systemie i małej liczbie zmian. Z czasem jednak rośnie liczba integracji, zależności, klientów, zamówień i konsekwencji błędu. Wtedy każda zmiana zaczyna kosztować więcej stresu, więcej ręcznej kontroli i więcej ryzyka biznesowego. Staging staje się wtedy nie luksusem, tylko sposobem na odzyskanie kontroli nad wdrożeniami.****
**
Drugi częsty scenariusz to moment przejęcia istniejącego systemu po innym zespole albo wcześniejszym wykonawcy. Klient ma działającą aplikację, ale nie ma pewności, jak dokładnie wygląda proces deployu, co siedzi na serwerze, które elementy są zapisane w repozytorium, a które istnieją tylko na produkcji. W takiej sytuacji staging nie służy wyłącznie do testów. On pomaga też zmapować rzeczywisty stan systemu i oddzielić to, co odtwarzalne, od tego, co działa tylko dlatego, że nikt jeszcze tego nie ruszył.****
**
Trzeci powód jest bardziej biznesowy niż techniczny. Firmy chcą skrócić czas uzgodnień i akceptacji zmian. Gdy nie ma stagingu, wszystko odbywa się albo na screenach, albo na lokalnych środowiskach developerów, albo bezpośrednio na produkcji. To utrudnia komunikację z klientem końcowym, zespołem marketingowym, osobą od sprzedaży czy managerem projektu. Staging daje wspólne miejsce, w którym można coś zobaczyć, sprawdzić i zaakceptować przed wdrożeniem. To porządkuje nie tylko development, ale też sam proces decyzyjny wokół zmian.****
**
Dlatego firmy zgłaszają się po staging zwykle wtedy, gdy próbują rozwiązać jeden z kilku realnych problemów: zbyt ryzykowne wdrożenia, brak miejsca do testów, chaos przy przejmowaniu systemu, trudność w akceptacji zmian albo zbyt duża zależność od produkcji. Sam staging nie naprawia wszystkiego automatycznie, ale bardzo często jest pierwszym krokiem do bardziej przewidywalnej pracy z istniejącym systemem.****
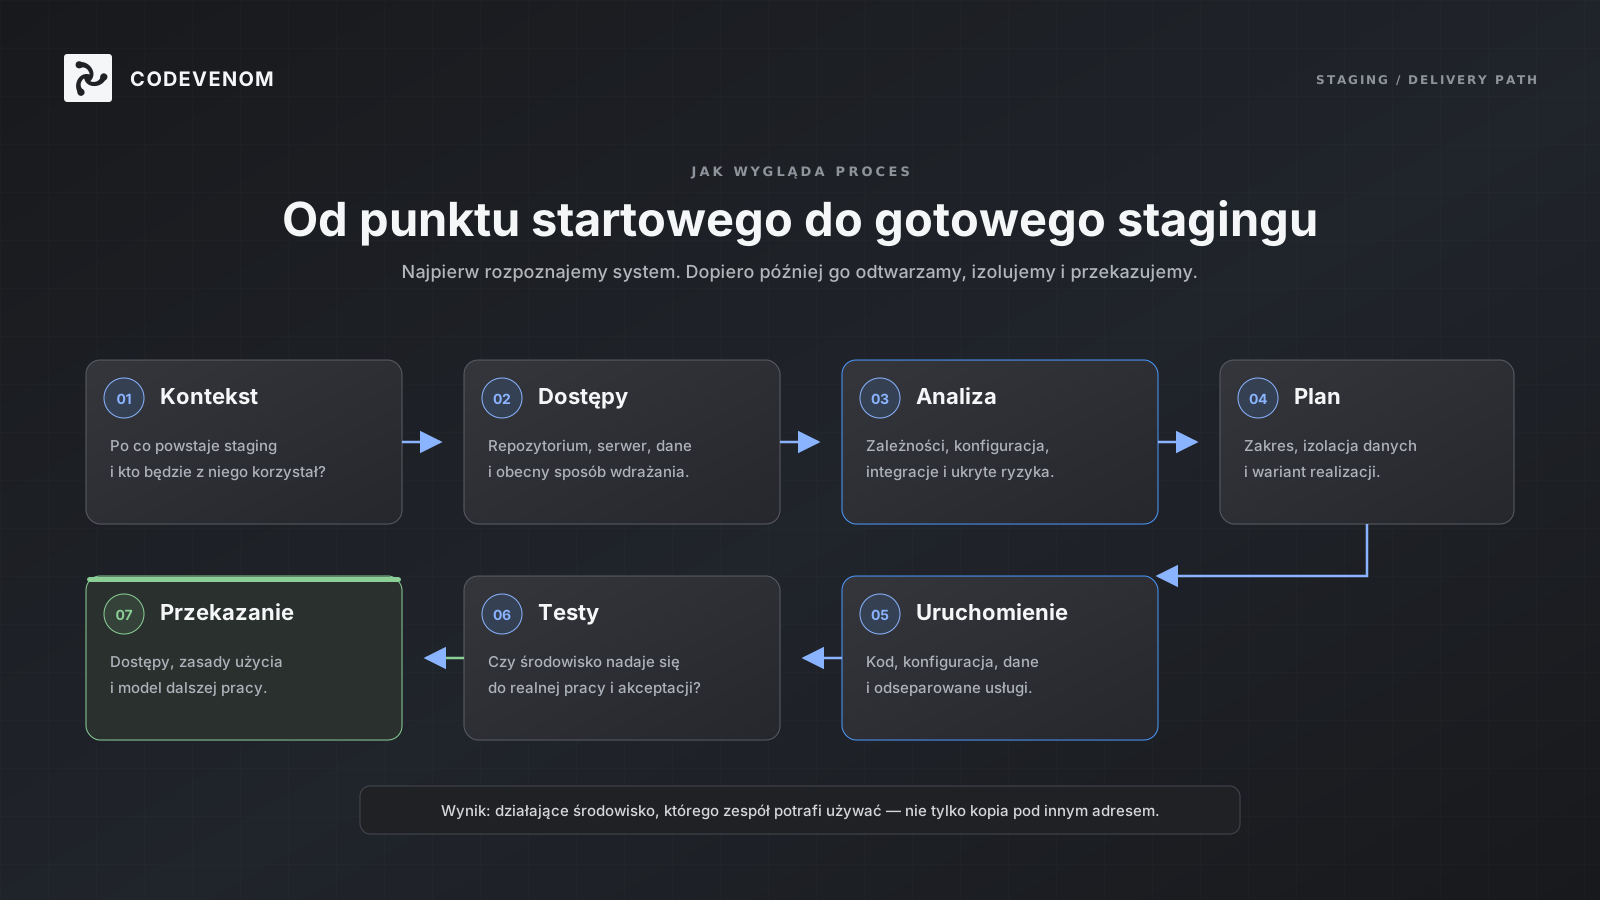
W CODEVENOM nie podchodzimy do stagingu jak do prostego „postawienia kopii aplikacji”. Najpierw trzeba zrozumieć, co dokładnie istnieje, z czego ten system się składa i na ile da się go bezpiecznie odtworzyć poza produkcją. Dlatego cały proces zaczyna się od krótkiego wejścia diagnostycznego, a dopiero potem przechodzi do właściwej realizacji.****
**
Krok 1 to brief i zebranie kontekstu. Na tym etapie ustalamy, jaki system ma dostać staging, po co to środowisko jest potrzebne i kto będzie z niego korzystał. Inaczej buduje się staging pod development i testy techniczne, a inaczej pod akceptację zmian przez biznes, marketing albo klienta końcowego. Już tutaj wychodzi też, czy mówimy o prostym serwisie, sklepie z płatnościami i zamówieniami, czy o aplikacji spiętej z zewnętrznymi usługami.****
**
Krok 2 to zebranie dostępów i materiałów wejściowych. Sprawdzamy, czy istnieje repozytorium, jaki jest dostęp do serwera, jak wygląda baza danych, gdzie są pliki, jak dziś działa deploy i czy istnieje jakakolwiek dokumentacja. To ważny moment, bo bardzo często dopiero tutaj okazuje się, czy system jest odtwarzalny w uporządkowany sposób, czy część wiedzy siedzi wyłącznie na produkcji.****
**
Krok 3 to analiza techniczna punktu startowego. Patrzymy, jak uruchamiany jest system, jakie ma zależności, z czego korzysta i co trzeba odtworzyć, żeby staging miał sens. Nie chodzi tylko o sam kod. Trzeba sprawdzić też konfigurację środowiska, usługi zewnętrzne, cron joby, storage, kolejki, integracje, certyfikaty i wszystko to, co może sprawić, że aplikacja na stagingu będzie wyglądała poprawnie, ale nie będzie działała tak jak produkcja.****
**
Krok 4 to plan realizacji. Po analizie układamy konkretny wariant działania. Określamy, gdzie stanie staging, jak będzie odseparowany od produkcji, skąd weźmiemy dane, co trzeba zamockować albo odłączyć i jakie są ograniczenia. Na tym etapie można też jasno powiedzieć, czy temat jest prosty, czy wymaga dodatkowego porządkowania infrastruktury albo procesu wdrożeń.
**
**
Krok 5 to konfiguracja i uruchomienie aplikacji. Wdrażamy kod, ustawiamy zmienne środowiskowe, łączymy potrzebne usługi, konfigurujemy bazę danych, pliki i wszystko, co jest potrzebne, żeby system realnie działał w środowisku staging. Czasem ten etap jest prosty, a czasem właśnie tutaj wychodzą rzeczy, które wcześniej były zaszyte tylko na produkcji.****
**
Krok 6 to testy i weryfikacja. Sprawdzamy, czy staging się uruchamia, czy aplikacja działa zgodnie z założeniami, czy nie ma problemów z logowaniem, routingiem, integracjami, zasobami statycznymi albo procesami w tle. To jest moment, w którym weryfikujemy nie tylko „czy działa”, ale też na ile to środowisko nadaje się do realnej pracy.****
**
Krok 7 to przekazanie i opisanie dalszego modelu pracy. Klient dostaje gotowe środowisko wraz z dostępami, podstawową informacją, jak z niego korzystać i co dalej można na nim robić. Jeśli trzeba, dopinamy też kolejny krok, czyli uporządkowanie procesu deployu, rozdzielenie środowisk albo przygotowanie gruntu pod dalszy rozwój systemu.****
Żeby sensownie wystartować z tematem stagingu, nie potrzebujemy od klienta idealnie poukładanego systemu ani pełnej dokumentacji. Potrzebujemy przede wszystkim punktu wejścia, który pozwoli nam zrozumieć, z czego dziś składa się aplikacja i co realnie da się odtworzyć poza produkcją. Im więcej rzeczy jest uporządkowanych, tym szybciej idzie praca, ale brak części materiałów nie oznacza automatycznie, że temat jest niemożliwy.****
**
Na starcie najważniejsze są dostępy do kodu albo do miejsca, w którym system dziś działa. Najlepiej, jeśli istnieje repozytorium i można zobaczyć aktualny stan aplikacji, historię zmian oraz sposób organizacji projektu. Jeśli repo nie ma albo nie jest kompletne, potrzebny jest przynajmniej dostęp do serwera, żeby zobaczyć, jak system jest dziś uruchomiony, gdzie leżą pliki, jaka jest konfiguracja i co faktycznie działa na produkcji.****
**
Drugim ważnym obszarem są dostępy do infrastruktury. Chodzi o serwer, panel hostingowy, usługę cloudową, DNS, reverse proxy, bazę danych, storage i inne elementy, które mogą mieć wpływ na odtworzenie środowiska. Nie zawsze potrzebujemy wszystkiego od razu, ale musimy wiedzieć, kto ma dostęp, co istnieje i czy można przygotować osobne środowisko bez naruszania produkcji.****
**
Trzecia rzecz to informacja o samym systemie i jego zależnościach. Dobrze jest wiedzieć, w jakiej technologii działa aplikacja, jak wygląda obecny sposób deployu, czy są integracje z zewnętrznymi usługami, czy system korzysta z cronów, kolejek, webhooków, płatności, mailingu, usług plikowych albo zewnętrznych API. To nie musi być od razu rozbudowany dokument techniczny. Często wystarczy krótki opis i kilka konkretnych odpowiedzi, które pozwalają szybciej zmapować sytuację.****
**
Kolejna sprawa to baza danych i pliki. Musimy ustalić, czy staging ma działać na kopii danych produkcyjnych, na danych zanonimizowanych, na wersji testowej albo na pustej bazie z podstawowym seedem. To ważne nie tylko technicznie, ale też biznesowo i prawnie, bo w części systemów nie można po prostu skopiować wszystkiego 1:1 bez zastanowienia się nad bezpieczeństwem i zakresem danych.****
**
Dobrze też od razu wiedzieć, do czego staging ma służyć. Czy to ma być środowisko dla developerów, do testów przed wdrożeniem, do akceptacji przez biznes, do demo dla klienta, czy może do uporządkowania procesu wokół istniejącego systemu. Ten punkt często wydaje się prosty, ale w praktyce mocno wpływa na to, jak takie środowisko powinno być przygotowane i jak wiernie ma odwzorowywać produkcję.****
**
Na start najczęściej prosimy więc o kilka rzeczy: dostęp do repo albo serwera, informację o hostingu i infrastrukturze, opis technologii i integracji, informację o bazie danych i plikach oraz krótki kontekst biznesowy, po co staging ma powstać. To zwykle wystarcza, żeby przejść z etapu ogólnego zapytania do realnej oceny zakresu prac i sensownego planu działania.
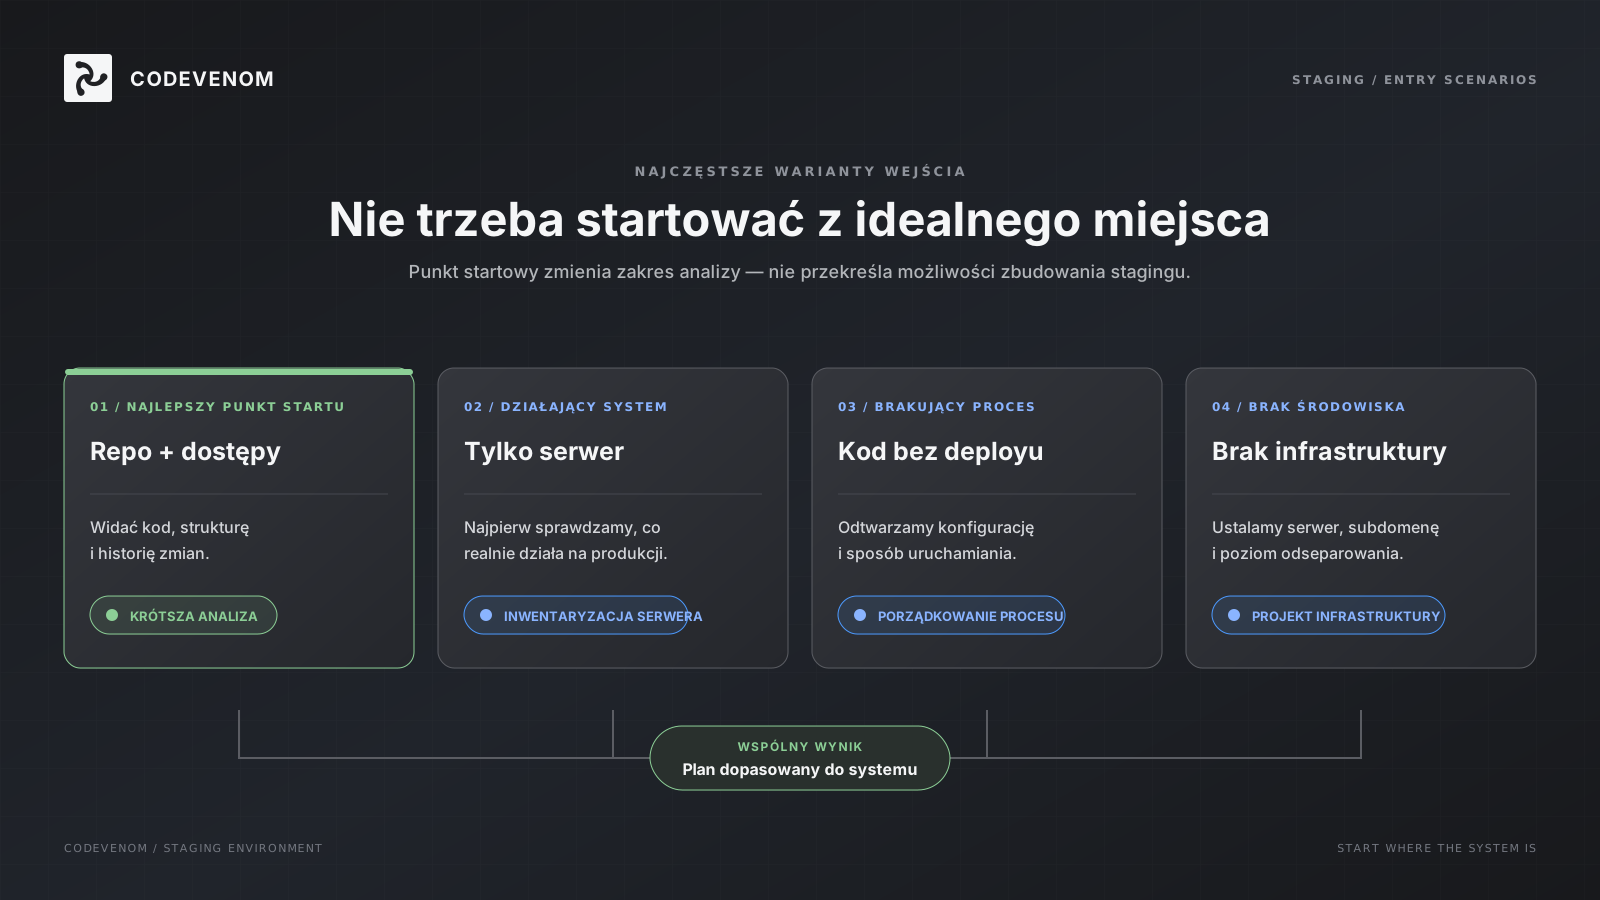
W zapytaniach o staging bardzo rzadko trafia do nas idealna sytuacja, w której wszystko jest opisane, dostępne i gotowe do sklonowania. Najczęściej start wygląda dużo bardziej roboczo. I to jest normalne. Kluczowe nie jest to, czy system jest perfekcyjnie poukładany, tylko z jakiego punktu startujemy i co da się z tego bezpiecznie zbudować.****
**
Pierwszy wariant to sytuacja, w której jest repozytorium i są dostępy. To zwykle najprostszy punkt wejścia, bo można od razu zobaczyć kod, strukturę projektu, sposób konfiguracji i szybciej ocenić, czego potrzeba do uruchomienia stagingu. Taki wariant nie gwarantuje jeszcze, że wszystko pójdzie bezproblemowo, bo repo może nie zawierać pełnej konfiguracji albo część wiedzy może nadal siedzieć poza kodem, ale daje najlepszy fundament do sprawnej pracy.****
**
Drugi wariant to sytuacja, w której istnieje tylko serwer albo działająca produkcja. Wtedy staging nadal da się zrobić, ale najpierw trzeba zrozumieć, co naprawdę działa na tym środowisku, jak system jest uruchamiany i które elementy są odtwarzalne. W praktyce oznacza to więcej analizy na wejściu, bo część konfiguracji może istnieć tylko na serwerze, część zależności może nie być nigdzie opisana, a proces wdrożeń może być oparty bardziej na ręcznych działaniach niż na uporządkowanym pipeline.****
**
Trzeci wariant to przypadek, w którym jest kod, ale nie ma uporządkowanej infrastruktury ani procesu wokół wdrożeń. Repozytorium istnieje, ale nie ma jasnego modelu deployu, nie wiadomo, które envy są aktualne, jak wyglądają zależności, gdzie są pliki, jak działają integracje albo co dokładnie trzeba odtworzyć, żeby staging był wiarygodny. Tu zwykle samo „postawienie środowiska” nie wystarcza. Trzeba po drodze uporządkować część technicznego zaplecza, żeby staging nie był tylko kopią z problemami przeniesionymi w nowe miejsce.****
**
Czwarty wariant to sytuacja, w której nie ma stagingu i nie ma nawet przygotowanego miejsca, gdzie można go postawić. Wtedy temat zaczyna się od infrastruktury. Trzeba ustalić, czy staging ma stanąć na osobnym serwerze, w istniejącej chmurze, na nowym zasobie, pod jaką subdomeną i z jakim poziomem odseparowania od produkcji. Dla klienta to często wygląda jak większy problem, niż jest w rzeczywistości, ale właśnie po to ten etap trzeba dobrze rozpisać, żeby od początku było jasne, co budujemy i na jakich warunkach.****
**
W praktyce większość projektów wpada gdzieś pomiędzy tymi wariantami. Klient może mieć repo, ale bez pełnych dostępów. Może mieć serwer i dokumentację, ale bez procesu deployu. Może mieć infrastrukturę, ale bez bezpiecznego modelu pracy na danych. Dlatego nie patrzymy na temat stagingu jak na jeden sztywny pakiet, tylko jak na proces dopasowany do realnego punktu startowego.****
**
To jest ważne także z perspektywy sprzedażowej, bo wiele firm zakłada, że skoro nie mają wszystkiego idealnie poukładanego, to nie ma sensu zaczynać tematu. A zwykle jest odwrotnie. Właśnie wtedy staging bywa potrzebny najbardziej, bo pomaga przejść z modelu „jakoś to działa” do modelu, w którym system da się rozwijać w sposób bardziej przewidywalny, bezpieczny i kontrolowany.****
Od strony technicznej budowa stagingu polega na tym, żeby odtworzyć środowisko możliwie zbliżone do produkcji, ale w sposób bezpieczny i odseparowany. To oznacza, że nie kopiujemy tylko samego kodu. Trzeba odtworzyć także warunki, w których ten kod realnie działa: konfigurację serwera, wersje usług, zmienne środowiskowe, bazę danych, pliki, integracje i sposób uruchamiania aplikacji.****
**
Pierwszy obszar to przygotowanie miejsca pod środowisko. Tworzymy lub konfigurujemy serwer, kontener, zasób w chmurze albo inne środowisko, na którym staging ma działać. Ustawiamy dostęp, domenę lub subdomenę, podstawowe zabezpieczenia, routing i wszystko to, co jest potrzebne, żeby aplikacja mogła działać poza produkcją w przewidywalny sposób.****
**
Drugi obszar to uruchomienie samej aplikacji. Wdrażamy kod, konfigurujemy runtime, zależności systemowe, usługi pomocnicze i zmienne środowiskowe. Jeśli aplikacja korzysta z cache, workerów, cronów, storage, kolejek albo zewnętrznych API, trzeba zdecydować, które elementy odtwarzamy 1:1, które izolujemy, a które zastępujemy bezpieczniejszym wariantem testowym.****
**
Trzeci obszar to baza danych i pliki. W zależności od systemu staging może działać na kopii produkcji, na danych częściowo zanonimizowanych, na uproszczonym zestawie testowym albo na pustej bazie przygotowanej pod development. To samo dotyczy plików, uploadów i assetów. Tutaj ważna jest nie tylko technika, ale też bezpieczeństwo danych i sens biznesowy. Staging ma pomagać pracować, ale nie może tworzyć niepotrzebnego ryzyka.****
**
Czwarty obszar to odcięcie stagingu od skutków ubocznych produkcji. Jeśli system wysyła maile, odpala webhooki, integruje się z płatnościami, ERP, kurierami, systemami magazynowymi albo innymi usługami zewnętrznymi, trzeba zadbać o to, żeby środowisko testowe nie wykonywało realnych akcji biznesowych. W praktyce oznacza to blokady, mocki, osobne klucze API, środowiska sandbox albo kontrolowane wyłączenie części funkcji.****
**
Piąty obszar to sprawdzenie powtarzalności uruchomienia i wdrożeń. Dobrze zrobiony staging nie powinien działać tylko „na teraz”. Powinien też dawać możliwość dalszej pracy. Dlatego tam, gdzie to ma sens, porządkujemy sposób deployu, startu aplikacji i podstawowej obsługi środowiska, żeby kolejne zmiany nie wymagały każdorazowo ręcznego zgadywania, co trzeba zrobić.****
**
Na końcu przechodzimy przez testy techniczne i weryfikację działania. Sprawdzamy, czy aplikacja się podnosi, czy logowanie działa, czy routing jest poprawny, czy dane są widoczne, czy integracje zachowują się zgodnie z założeniami i czy staging faktycznie nadaje się do testów, akceptacji albo dalszego developmentu.****
**
Z perspektywy klienta najważniejsze jest to, że budowa stagingu nie kończy się na uruchomieniu kopii systemu pod innym adresem. Chodzi o to, żeby stworzyć środowisko, które da się realnie wykorzystać do pracy, a nie tylko technicznie pokazać, że „coś działa”.
Przy istniejących systemach największy błąd polega na założeniu, że staging da się postawić zawsze w identyczny sposób i bez niespodzianek. W praktyce część rzeczy wychodzi dopiero wtedy, gdy zaczynamy wchodzić głębiej w kod, serwer, konfigurację i zależności. I to nie musi oznaczać, że projekt jest źle prowadzony. Po prostu wiele systemów rozwija się latami, przez różne osoby i w różnych warunkach, więc część wiedzy bywa rozproszona albo nieopisana.****
**
Jednym z najczęstszych problemów jest to, że repozytorium nie zawiera wszystkiego, co naprawdę jest potrzebne do uruchomienia systemu. Kod istnieje, ale część konfiguracji siedzi wyłącznie na serwerze, część usług została kiedyś ustawiona ręcznie, a część zależności nie jest nigdzie jasno opisana. W takiej sytuacji staging nadal da się zbudować, ale zakres analizy i odtwarzania rośnie, bo najpierw trzeba ustalić, co dokładnie odpowiada za działanie produkcji.****
**
Drugie ryzyko dotyczy integracji z zewnętrznymi usługami. System może być spięty z płatnościami, mailingiem, ERP, kurierami, systemami magazynowymi, CRM-em, webhookami albo zewnętrznym API. Jeśli nie podejdzie się do tego ostrożnie, staging może zacząć wykonywać realne akcje, których nikt nie chciał uruchamiać. Dlatego na etapie realizacji trzeba sprawdzić, które integracje można bezpiecznie odtworzyć, które trzeba zamockować, a które powinny działać wyłącznie w sandboxie albo zostać tymczasowo odłączone.****
**
Trzeci obszar to dane i bezpieczeństwo. Nie każdy system nadaje się do prostego skopiowania bazy produkcyjnej na staging. Czasem trzeba anonimizować dane, ograniczyć ich zakres albo przygotować bezpieczniejszy wariant testowy. To ważne nie tylko technicznie, ale też organizacyjnie i prawnie. Dla części klientów właśnie ten temat okazuje się kluczowy, bo staging ma pomagać w pracy, ale nie może tworzyć nowego ryzyka wokół danych użytkowników, klientów albo zamówień.****
**
Kolejne ograniczenie dotyczy różnicy między stagingiem a produkcją. Nawet dobrze przygotowane środowisko testowe nie zawsze będzie kopią 1:1. Czasem świadomie odłączamy część usług, ograniczamy obciążenie, podstawiamy inne klucze API albo nie odtwarzamy pełnej skali danych. I to jest normalne. Celem stagingu nie jest idealna iluzja produkcji za wszelką cenę, tylko środowisko, które daje sensowną, bezpieczną i użyteczną przestrzeń do pracy.****
**
Warto też uczciwie powiedzieć, że podczas budowy stagingu często wychodzą na jaw rzeczy, które wcześniej były ukryte przez sam fakt, że produkcja „po prostu działa”. Dopiero przy próbie odtworzenia systemu okazuje się, że proces deployu nie jest powtarzalny, że część plików istnieje tylko lokalnie na serwerze, że są ręczne kroki, których nikt wcześniej nie opisał, albo że system zależy od usług, o których zespół już prawie nie pamiętał. Z naszej perspektywy to nie jest problem sam w sobie. To cenna informacja, bo pokazuje, gdzie system wymaga większego uporządkowania.****
**
Dlatego przy takich projektach ważne jest rozsądne oczekiwanie: staging nie zawsze jest zadaniem typu „szybka kopia i gotowe”. Czasem to prosty temat, a czasem pierwszy etap porządkowania technicznego zaplecza systemu. Im wcześniej nazwiemy te ryzyka i ograniczenia, tym mniej nieporozumień później i tym łatwiej poprowadzić projekt w sposób przewidywalny.
Na końcu klient dostaje przede wszystkim działające środowisko staging, które można wykorzystać do testów, akceptacji zmian albo dalszego developmentu bez wchodzenia od razu na produkcję. To jest najważniejszy efekt całej pracy, ale nie jedyny. Równie ważne jest to, żeby klient wiedział, co dokładnie zostało przygotowane, jak z tego korzystać i jakie są granice tego środowiska.****
**
W praktyce przekazanie nie powinno kończyć się na samym linku do subdomeny. Klient powinien dostać dostępy, podstawowy opis środowiska, informację, jak wygląda wejście na staging, gdzie są najważniejsze elementy i kto może z tego korzystać. Jeśli w ramach projektu były podejmowane konkretne decyzje techniczne, na przykład dotyczące danych testowych, integracji zewnętrznych, blokad maili, webhooków albo ograniczeń względem produkcji, to też trzeba to jasno nazwać. Dzięki temu staging nie staje się „czarną skrzynką”, tylko normalnym narzędziem do pracy.****
**
W zależności od zakresu prac klient może dostać także uporządkowany model dalszego działania. Czasem będzie to tylko informacja, jak wrzucać kolejne zmiany na staging. Czasem prosty opis deployu. A czasem lista rzeczy, które warto zrobić jako kolejny krok, jeśli staging ujawnił większe braki w procesie albo infrastrukturze. To ważne, bo samo uruchomienie środowiska jest tylko częścią wartości. Drugą częścią jest to, że klient zaczyna lepiej rozumieć własny system i wie, co dalej zrobić, żeby pracować z nim bezpieczniej.****
**
Dobre przekazanie oznacza też uczciwe powiedzenie, co staging już obejmuje, a czego jeszcze nie obejmuje. Jeśli środowisko nie odwzorowuje produkcji 1:1, jeśli część integracji działa w trybie testowym albo jeśli dane zostały ograniczone lub zanonimizowane, klient powinien to wiedzieć. To nie jest wada. To element odpowiedzialnego wdrożenia. Lepszy jest staging, którego zasady są jasno opisane, niż środowisko, które wygląda kompletne, ale w praktyce wprowadza zespół w błąd.****
**
Z naszej perspektywy dobrze zakończony projekt stagingowy to taki, po którym klient ma nie tylko nowe środowisko, ale też większą przewidywalność pracy wokół zmian. Wie, gdzie sprawdzać rzeczy przed produkcją, wie, z czego może korzystać zespół, i nie musi za każdym razem wracać do punktu pod tytułem „zobaczmy najpierw, czy da się to bezpiecznie ruszyć na live”. I właśnie dlatego przekazanie jest ważną częścią całego procesu, a nie formalnością na końcu.
To zależy głównie od punktu startowego. Jeśli istnieje repozytorium, są dostępy, infrastruktura jest w miarę uporządkowana, a system nie ma wielu ukrytych zależności, staging da się przygotować stosunkowo sprawnie. Jeśli jednak część konfiguracji siedzi tylko na produkcji, brakuje dostępu do kluczowych elementów albo system jest spięty z wieloma integracjami, etap analizy i odtworzenia środowiska będzie dłuższy.****
**
Na czas realizacji wpływa też to, jak wiernie staging ma odwzorowywać produkcję. Inaczej wygląda środowisko do podstawowych testów i akceptacji zmian, a inaczej takie, które ma możliwie dokładnie odtwarzać zachowanie systemu razem z usługami zewnętrznymi, danymi i procesem deployu.****
**
Dlatego samo pytanie „czy da się to zrobić szybko” ma sens dopiero wtedy, gdy wiadomo, z czym dokładnie startujemy, jakie są ograniczenia i do czego staging ma finalnie służyć. Właśnie dlatego na początku zawsze potrzebna jest krótka analiza, bo dopiero ona pozwala uczciwie ocenić zakres pracy zamiast zgadywać.
Najczęściej problem nie polega na tym, że firma nie chce zrobić stagingu. Problem polega na tym, że nie wie, z jakiego punktu startuje. Czy kod jest kompletny. Czy da się odtworzyć środowisko poza produkcją. Czy integracje są pod kontrolą. Czy wiadomo, co zrobić z bazą danych, plikami i dostępami. Bez tego bardzo łatwo wejść w temat z błędnym założeniem, że staging to szybka techniczna kopia, a dopiero później odkryć rzeczy, które wydłużają projekt albo zmieniają jego zakres.****
**
Właśnie dlatego przygotowaliśmy osobny materiał, który pomaga to ocenić przed startem. To checklista gotowości systemu do postawienia stagingu, zbudowana tak, żeby szybko sprawdzić najważniejsze obszary: kod i repozytorium, serwer i infrastrukturę, bazę danych, pliki, integracje zewnętrzne, sposób deployu i realny cel biznesowy środowiska.****
**
Taka checklista pomaga w dwóch rzeczach. Po pierwsze, daje szybką diagnozę, czy temat jest prosty, czy wymaga najpierw uporządkowania kilku elementów. Po drugie, skraca etap wyjaśniania na spotkaniach i w wiadomościach, bo zamiast zaczynać od ogólnego „potrzebujemy stagingu”, można od razu przejść do konkretu: co już istnieje, czego brakuje i jaki wariant wejścia ma sens.****
**
Jeśli chcecie sprawdzić, na ile Wasz system jest gotowy na staging, pobierzcie checklistę i przejdźcie przez nią krok po kroku. To najprostszy sposób, żeby przed decyzją ocenić, czy temat jest gotowy do realizacji od razu, czy najpierw trzeba uporządkować punkt startowy.